
ユーザーガイド
GitHubでこのページを編集
アプリを起動した瞬間から面接獲得までの、すべてのページの完全ウォークスルー
です。以下の各 ## 見出しは、サイドバーの項目またはワークフローのフェーズ
に対応しています。初回は上から下へ読み、後で特定のセクションへはヘルプ
サイドバーの目次からジャンプしてください。
回り方(v2 シェル)。 サイドバーは折りたたみ可能なグループ — ソーシング、判断、応募、ネットワーキング、分析、設定 (
nav.group.*) — に整理されており、セクションを開くと展開され、 離れたときの状態を保持します。任意のページにスターを付けると お気に入り に固定され、Cmd/Ctrl+K(またはサイドバー上部の コマンドメニュー ボタン、nav.v2.palette)でどこからでもあいまい 検索でページへジャンプできます。どのページもタイトルは即座に表示され、 データの読み込み中はグレーのシマー状の行が流れるため、ナビゲーションが 白紙に見えることはありません。そしてどのページも白紙のまま出迎えることは ありません:最初は空の 4 ページ — オートパイプライン、 応募チェックリスト、バッチ、資金調達企業 — には実例と、それを 埋めるための 1 つのアクション(v2empty.exampleTag)が表示されます。
対象読者: この UI を
career-opsチェックアウト内に置いてbash bin/start.shを実行したばかりの方。career-ops の予備知識は 不要です。
career-ops について
career-ops は、任意の AI コーディング CLI (Claude Code、Cursor、Codex、OpenCode、Antigravity CLI、Grok Build CLI、Qwen Code、Kimi、GitHub Copilot CLI、Gemini CLI (legacy) — 同じスラッシュコマンド・サーフェスで他の Claude 互換 CLI も動作します) 内で スラッシュコマンドとして動作するオープンソースの求職システムです。 モデル非依存です。各求人をあなたの CV と照らし合わせ、6 次元 0.0–5.0 のルーブリックで評価し、ロールに合わせた PDF レジュメを生成し、 すべての応募をあなたのマシン上にローカルで記録します。
正規リファレンス (初回インストール時はこの順で読んでください):
- What is career-ops — システム、原則、概念インベントリ。
- Scan job portals — 求人を発見し、Pipeline に投入します。
- Apply for a job — Playwright のフォーム読込を伴う完全な応募フロー。
- Batch-evaluate offers
—
batch-runner.shで 10 件以上の JD をまとめて採点します。 - Set up Playwright — Chromium のインストールと、PDF・フォーム入力用 MCP の登録。
- career-ops による求人スコアリングの仕組み — スコアリングメソドロジー: 5 つの評価次元 + 総合スコア、4.0 の応募しきい値、そして このシステムが絶対に行わないこと。cvstart.org/methodology でもあなたの言語で要約を確認できます。
基本原則 (出典: career-ops.org/docs/introduction/what-is-career-ops):
- オープンソース、本気で — MIT ライセンス、有料ティアなし、 ウェイトリストなし、テレメトリなし、アカウントなし。本システムは 有料層・アカウント・テレメトリなしで運用されます。コードへの貢献は リリース前にコミュニティレビューを経ます。
- データ主権 —
cv.md、config/profile.yml、data/、reports/、interview-prep/は、明示的にプッシュしない限り あなたのノート PC を離れません。ローカルマシンで実行し、データ主権を 完全に保持します。 - AI 非依存アーキテクチャ — career-ops はモデルを同梱しません。 既存の AI コーディング CLI 内のコマンドとして機能します。 プロバイダ (Anthropic ↔ Gemini ↔ OpenAI) を切り替えても評価履歴は 一貫して保たれます。
- 人間が制御する送信 — career-ops は回答を起草しフォームを 開きますが、Submit はあなたがクリックします。本システムは 自動応募を行いません。システムは構造と評価を提供し、最終的な送信 権限は人間が保持します。
- 構造化された検索 — 多数の応募を伴う能動的・意図的な求職を 想定した設計です。単発応募ツールでもレコメンドエンジンでも ありません。セットアップは約 15 分、ターミナル操作に慣れていることを 前提とします。
career-ops が「やらないこと」 (明示的な非ゴール):
- 自動応募ツールではありません。フォームを代わりに送信しません。
- レジュメ自動再構築ツールではありません。JD ごとに調整しますが、 存在しない経験を捏造しません。
- LinkedIn 最適化ツールではありません。あなたのプロフィールは あなたの責任です。
- SaaS UI の裏に隠れたスプレッドシート代替品ではありません。 データはファイルシステム上のプレーンな markdown です。
主要概念 (career-ops が扱うすべての成果物):
| 概念 | 内容 |
|---|---|
| Mode | modes/<slug>.md 配下のプロンプトテンプレート。組込み: oferta、deep、apply、pipeline、batch、contacto、followup、interview-prep、patterns、project、training、ofertas、auto-pipeline、pdf、latex、scan、tracker。 |
| Archetype | config/profile.yml のターゲットロールプロファイル。ルーブリックはアクティブな archetype に対してスキル一致を重み付けします — 単一で最重要のフィールドです。 |
| Pipeline | data/pipeline.md — 評価待ちの JD URL の受信箱。 |
| Tracker | data/applications.md — すべての評価 + 応募ステータスの履歴的な GFM テーブル。 |
| Report | reports/<NNN>-<company>-<DATE>.md — JD ごとの完全な A–F 評価。ヘッダに score と legitimacy を含みます。 |
| Scan history | data/scan-history.tsv — 追記専用ログ。スキャン間で重複を防止します。 |
| Proof points | cv.md から抽出した STAR+R 形式の根拠ブロック。評価・apply 回答・面接準備で再利用されます。 |
| JD store | jds/jd-<date>-<ts>.txt — 評価時に保存された求人説明の原文。監査証跡用です。 |
| Interview-prep | interview-prep/<company>-<role>.md — 深掘りリサーチのブリーフとラウンドごとの 1 ページ資料。 |
| Batch additions | batch/tracker-additions/*.tsv — batch-runner.sh によりキューされた、tracker へのマージ待ち行。 |
career-ops と career-ops-ui (本アプリ)
| career-ops (CLI) | career-ops-ui (本アプリ) | |
|---|---|---|
| 実行場所 | Claude Code / Cursor / Codex / OpenCode / Antigravity CLI / Grok Build CLI / Qwen Code / Kimi / GitHub Copilot CLI / Gemini CLI (legacy) 内 | ブラウザの http://127.0.0.1:4317 |
| 表面 | /career-ops <mode> スラッシュコマンド |
サイドバー、ワークフローごとに 1 ページ |
| フォーム入力 | あり、Playwright MCP 経由 | なし — チェックリスト生成、CLI で仕上げ |
generate-pdf.mjs |
📄 Generate PDF (#/cv、#/reports/:slug、#/evaluate、#/deep、#/interview-prep) |
|
| データファイル | career-ops-ui と共有 | career-ops と共有 |
career-ops-ui は 純粋な追加 です。career-ops/ 内には一切変更が
ありません。両表面は同じ cv.md、config/profile.yml、
portals.yml、data/、reports/、interview-prep/、modes/ を
共有します。
Score 別のアクション閾値
JD に評価が付くと、score によって次のステップが決まります (正規表は career-ops.org/docs/introduction/what-is-career-ops より):
| Score | 次のステップ |
|---|---|
| ≥ 4.5 | /career-ops apply を実行 — 高フィット、即応募。 |
| 4.0 – 4.4 | 応募する、または /career-ops contacto で先にウォームイントロ。 |
| 3.5 – 3.9 | /career-ops deep を実行 — 決定前に会社・ロールを調査。 |
| < 3.5 | 特別な個人的理由がなければスキップ。 |
career-ops-ui の #/dashboard と #/tracker は 4.0 以上の行を
ハイライトするので、何も再実行することなくアクションを選べます。
外部ドキュメント
スキャン、評価ルーブリック、batch 処理、apply フロー、Playwright セットアップを含む career-ops エンジンの完全リファレンスは career-ops.org/docs にあります:
1. クイックスタート — 「CV 作成」から「応募 + メッセージ送信」まで完全ステップ
ボタン単位の正規プレイブックです。初回は順番通りに進めてください。 各ステップは正確なルート、正確なボタン、成功時に表示される内容を 明示しています。第 2 章以降は各フェーズをより詳しく説明します。
ガイドに質問。 サイドバー(ヘルプの下)の**ガイドに質問 💬**を開いて使い方を質問 — あなたの言語でこのガイドのみから回答し、履歴書は決して読みません。 同じアシスタントはどのページからもワンタップで開けます — ロボットのチャットボタンが右下(右から左の言語では左下)に浮かびます。作業を中断せずにタップして質問できます。
ワンコマンドで起動と初期化。 ターミナルから、UI に触れずに ブートストラップ一式を実行できます:
career-ops-ui setup      # 依存関係のインストール → doctor → サーバー起動
career-ops-ui init       # LLM プロバイダーを選択し、そのキーを貼り付け (エコーは抑制)
career-ops-ui doctor     # いつでも再検証 (終了コード 0 ⇔ 必須項目がすべて緑)
career-ops-ui run        # http://127.0.0.1:4317 でサーバーを起動するだけ
career-ops-ui open       # ブラウザのダッシュボードタブを開いて最前面に表示
setup/runの後、ブラウザタブは自動的に開かれ 最前面に表示されます (v1.43.0)。career-ops-ui openはオンデマンドで 同じ動作をするので、ダッシュボードタブを探し回る必要はありません。NO_OPEN=1でヘッドレス/CI 起動時の自動オープンを無効化できます。
setupはチェーン全体を自分で実行します。initは#/configの API キータブが使うのと同じ検証済みパスを通じて、親のcareer-ops/.envにキーを書き込み、LLM_PROVIDER(auto|claude|gemini) を設定します。これはライブの evaluate / deep / mode / 自動パイプラインのルートが従います。CI 形式:career-ops-ui init --provider claude --anthropic-key sk-ant-… --yes。 UI のほうがよいですか? 以下の手順を続けてください。
A. セットアップ (一度のみ、約 5 分)
career-ops-ui は career-ops/web-ui/ に配置する必要があります(親の career-ops プロジェクト内にネスト)。../ 経由で親フォルダーの cv.md、config/、data/ を読み込み、単独では動作しません。git pull 後に career-ops-ui init が見つからない場合は、cd career-ops/web-ui && npm install && npx career-ops-ui init を実行してください。
ステップ 1 — http://127.0.0.1:4317 でアプリを開きます。
起動していない場合は、リポジトリのルートで bash bin/start.sh を
実行します。Dashboard (#/dashboard) が読み込まれます。
ステップ 2 — 左サイドバーの ❤ Health をクリックします。
必須チェックがすべて緑である必要があります:
cv.md、config/profile.yml、portals.ymlが存在- API キーが設定済み (
ANTHROPIC_API_KEY/GEMINI_API_KEYの 少なくとも一方) - Playwright がインストール済み (Generate PDF を使う場合のみ必須)
赤がある場合、ページは修正すべき正確なファイル名または環境変数名を 示します。Health が緑になるまで先に進まないでください。
ステップ 3 — サイドバーの ⚒ App settings をクリックします。
API keys & runtime タブが開きます。
ANTHROPIC_API_KEY(推奨 — 長文採点の品質が高い) かつ/またはGEMINI_API_KEYを貼り付けます。キーは https://console.anthropic.com/settings/keys または https://aistudio.google.com/apikey から取得します。- 💾 Save をクリック。続いて ▶ Test Anthropic (または Gemini) をクリック — 小さな往復通信でキーが動作することを 確認します。
ステップ 4 — 同じページの Profile タブに切り替えます。
これは config/profile.yml の直接 YAML エディタです。
少なくとも以下を編集します:
candidate.full_name— プレースホルダ (“Jane Smith”) を あなたの実名に置き換えるcandidate.email、linkedin、github— カバーレターで使用target.roles— 応募する職種タイトルtarget.comp_total_min_usd— 最低総報酬。これを下回るオファーは 全評価のセクション D でフラグされますtarget.archetypes— 受け入れるキャリアパターン (最も影響の 大きいフィールド)
💾 Save をクリック。サーバは YAML を検証し、正規の
# Career-Ops Profile Configuration ヘッダを刻印します。
B. CV (一度のみ、約 10 分)
ステップ 5 — サイドバーの ✎ CV をクリックします。
2 カラム: 左にエディタ、右にライブプレビュー。
ステップ 6 — エディタを埋める方法を 1 つ選びます:
- 既存のレジュメをアップロード — 📁 Upload CV をクリックし、
.docx / .odt / .rtf / .pdf / .html / .txt / .mdの いずれかを選択。サーバは pandoc または pdftotext で markdown に 変換し、XSS をサニタイズしてエディタに挿入します。変換結果を 必ずレビューしてください — 特に PDF はレイアウト忠実度が 落ちがちです。 - markdown を直接貼り付け — テキストエリアは markdown エディタ です。右ペインは LLM (および将来のリクルータ) が見る内容です。
- トーンのコツ: 箇条書き 1 つ = メトリクス付きの実績 1 つ。 1500 ワード以内。セクション順: Summary、Experience、Projects、 Education、Skills。
ステップ 7 — 💾 Save をクリック (CV ページの右上)。
サーバはサニタイズ (<script> / javascript: / インラインハンドラを
除去) して cv.md に書き込みます。トースト: “Saved”。
ステップ 8 (任意) — 📄 Generate PDF をクリック。 親プロジェクトの
generate-pdf.mjs を実行し (Playwright 必須)、新規 PDF が完了時に
ブラウザへ自動ダウンロードされます。ページ下部のリストは過去に
生成されたファイルもすべて保持します。
C. 求人を探す (スキャンあたり約 2 分)
ステップ 9 — サイドバーの 🌐 検索 をクリックします。
portals.yml に関心のあるボードが列挙されていることを確認します
(本ヘルプの第 5 章)。🌐 今すぐスキャン ボタンを押します。
スキャナーが Greenhouse / Ashby / Lever / Workable / SmartRecruiters
/ Workday (英語圏ボード) と、有効化されていれば hh.ru / Habr
Career (ロシア圏ボード) を巡回する間、ライブ SSE ログがストリーム
表示されます。
ステップ 10 — スキャン完了後、結果をレビューします。 任意の会社タグをクリックでフィルタ、↗ アイコンで会社の採用ページを 新規タブで開きます。タイトルフィルタを通過したすべての求人が Pipeline にキューされます。各結果行は求人をコンパクトな 2 行に 収めます — 上段にタイトル、下段に小さなアイコンの詳細行 (タイトル適合、レベルによるブースト、適合スコア、ソース、日付) — そして長い結果リストはページ分割されます。
D. オファーを採点する (JD あたり約 30 秒)
ステップ 11 — サイドバーの Pipeline をクリックします。
スキャナーがキューしたすべての URL が表示されます。エントリを
クリックすると JD がインラインでプレビューされます。
ステップ 12 — 任意の JD 横の ▶ Evaluate をクリック。
#/evaluate にジャンプします。API キーが設定されていればライブ実行、
されていなければ手動プロンプトが返り、自分の LLM に貼り付けます。
ライブモードはあなたの CV に対する A–G セクション
(Role / Company / Compensation / Risk / Stretch / Cultural fit /
Verdict) で 0–5 の score を生成します。Save 先は
reports/<date>-<slug>.md。
ステップ 13 — サイドバーの Reports をクリックして最新の
評価をレビューします。comp_total_min_usd 未満のものはセクション D
で赤くフラグされます。Verdict: pursue のものがショートリストです。
E. ショートリスト企業を決定し深掘りリサーチ (約 3 分)
ステップ 14 — 検討する求人を選びます。サイドバーの Deep research
をクリック。 会社名とロールを入力します。モデルが 7 セクションの
企業ブリーフ (ミッション、最近のニュース、技術スタック、採用
シグナル、報酬ベンチマーク、リスク、推奨アングル) を生成します。
Save 先は interview-prep/<company>-<role>.md。
F. 応募する (応募あたり約 5 分)
ステップ 15 — サイドバーの Apply checklist をクリック。
求人 URL と JD を貼り付けます。ヘルパーが段階的な送信
チェックリストを生成します:
- ロールに合わせたカバーレター下書き (あなたの
cv.md+profile.ymlを使用) - JD からミラーすべき具体的キーワード
- 添付すべきファイル (CV の PDF — ステップ 8 参照)
- 応募先 (アグリゲータのリダイレクトではなく、正規の採用ページ URL)
- リマインダ: 絶対に自動送信しない — 最終レビューと送信は 常に手動。
ステップ 16 — 採用ページを新規タブで開きます。 apply チェックリストを ToDo リストとして使います。会社の実際のフォームから 送信します。ステップ 8 で生成した PDF を添付します。
ステップ 17 — 実在の人間に連絡します。
サイドバーで Outreach モード (#/contacto) を開きます。
モデルがステップ 14 の会社ブリーフに合わせた短い LinkedIn / メール
メッセージを起草します。冒頭をパーソナライズ (深掘りブリーフからの
具体的な詳細を 1 つ) して送信します。
G. 追跡とフォローアップ (継続)
ステップ 18 — サイドバーの Tracker をクリックして応募の
行を追加します: company、role、score、status Applied、レポートへの
リンク、深掘りブリーフへのリンク。日付は自動入力されます。
ステップ 19 — 1 週間後、Follow-up モード (#/followup)
を開きます。 元の応募を参照する丁寧な確認メールを下書きします。
送信して、tracker のステータスを Followed up に更新します。
ステップ 20 — 面接案内が届いたら、Interview prep モード
(#/interview-prep) を実行します。 特定の会社 + ステージ
(システム設計 / 行動 / コーディング) 向けの的を絞った準備を生成します。
深掘りブリーフから自動で情報を引いてきます。
ステップ 21 — オファー獲得? Tracker ステータスを Offer に更新
し、評価レポートの報酬セクションを再確認 — あなたの最低受諾額が
そこに記載されています。
TL;DR — サイドバーの順序 = ワークフローの順序
Health → App settings → Profile → CV → Scan → Pipeline → Evaluate → Reports → Deep research → Apply checklist → Outreach → Tracker → Follow-up → Interview prep → Activity log
サイドバーは同じページをフェーズ別にグループ化して
(ソーシング → 判断 → 応募 → …)、ワークフローの順序と
メニューの順序が一致したまま保たれます。一覧をなぞるより 3 文字打つ
ほうが早ければ、Cmd/Ctrl+K でコマンドメニュー
(nav.v2.palette)を開けます。以上です。21 ステップ、ボタン単位で、
ゼロからオファーまで。
ワンクリック Auto-pipeline (#/auto) — 21 ステップの近道
特定の求人を素早く採点したいだけなら手動手順を飛ばせます。サイドバー → ✨ Auto-pipeline(またはダッシュボードの ✨ ボタン)が専用画面を開きます:求人 URL を貼り、Enter を押すか auto-pipelineを実行(auto.run)をクリックすると、サーバが全チェーンを 1 パスで観察可能に実行します:
- URL を検証 (
auto.step.validate) — SSRF 安全チェック (isValidJobUrl);ループバック /file:/ プライベート IP / スクリプト文字を拒否します。 - 求人説明を取得 (
auto.step.fetch) —safeGet(DNS 固定、 リダイレクト再検証)が JD を取得 + サニタイズします。 - CV と照合評価 (
auto.step.evaluate) — Anthropic(優先)→ Gemini フォールバック → キーがなければ手動プロンプト。 - レポート保存 (
auto.step.report) — ヘッダにスコアと正当性を 載せてreports/<slug>.mdに書き込みます。 - トラッカーに追加 (
auto.step.tracker) —data/applications.mdに行を追加します。
ライブフィードバックは縦型 ステッパー です(各ステップが
running → done / failed と点灯;aria-current がアクティブなステップを
示し、丁寧なスクリーンリーダー用ライブ領域がすべての遷移を読み上げます)。
成功すると結果カードが、保存されたレポート(レポートを表示,
auto.viewReport)と トラッカー(auto.viewTracker)へ直接
リンクします。失敗したステップはメッセージ付きで赤くマークされ、
ボタンが再有効化されるため、リロードせずに URL を修正して再試行
できます。実行の進行中に新しい実行を開始しても安全です:古い実行は
古びた回答に二重に費やす代わりに、置き換えられました — 新しい実行が
リクエストされました(auto.superseded)と自分をマークします。
空のページはその唯一の入力欄について正直です:例 タグと
サンプルURLを試す ボタン(v2empty.auto.tryExample)が入力欄に
サンプル求人を流し込みます — 実行を押すまで何も走りません
(v2empty.auto.hint)。見て回るだけならコストはかかりません。
API キーなし? 手動モード:手順 3–5 が折りたたまれコピー用プロンプト。リンク可:#/auto?url=<enc>&go=1 で自動開始。
CLI (v1.38.0)。 1 コマンドで全チェーン:
career-ops-ui setup。動詞:career-ops-ui doctor(env/キー/ツール検査 — Health と同一エンジン;必須失敗で exit 1)、career-ops-ui run、career-ops-ui init(プロバイダ+キーウィザード、v1.39.0)。 プロバイダ (v1.39.0)。 API-keys タブにLLM_PROVIDERセレクト(auto=Anthropic→Gemini ·claude·gemini)とOPENAI_API_KEYフィールド(Codex/OpenCode CLI 側)を追加。career-ops-ui initが対話ウィザード。プロバイダ (v1.57.0)。 ヘッドレス・ライブ評価が Anthropic → Gemini → OpenAI → Qwen → OpenRouter → GitHub Models → Hermes → DeepSeek → GLM (Z.ai) → Kimi (Moonshot) → MiniMax → Mistral → Grok (xAI) → Together → Fireworks → Ollama → BytePlus Ark → Volcengine Ark(
auto順序、LLM_PROVIDERで固定)に拡張。OpenRouter —OPENROUTER_API_KEY一つで 300+ モデルにアクセス。OPENROUTER_MODELドロップダウンは OpenRouter のライブカタログを読み込み(サーバ側プロキシ、オフライン時は厳選フォールバック)。さらに修正: 改行/空白付きで貼り付けたキーを検証前にトリムするため、/#/configでどのプロバイダでも「validation failed」が出なくなりました。
2. アプリ設定と API キー (#/config)
v1.55 → v1.56 の新機能。 LLM キー未設定時は各画面の赤いバナーが ⚡ ライブ実行が手動プロンプトモードであることを示しここへ誘導;キー設定後はアクティブなプロバイダを示す控えめなチップになります。各 ⚡ ライブ実行ボタン(
#/auto、#/evaluate、#/deep、モード)の前に正直な推定コストを表示(例:「推定コスト: OpenAI gpt-5-codex · ~$0.04/eval」、手動モードは API コストなし)。#/scanは副次フィルタを 詳細フィルター ディスクロージャへ、#/trackerはクリック可能なファネルチップ + 任意のサーバーページネーション、#/pipelineは 1000 行超で仮想化。
AI CLIツール。 AI CLIツールタブは、サーバーにどのエージェントCLI(Claude Code、Cursor、Codex、Gemini、OpenCode、Copilot、Qwen、Antigravity、Kimi CLI、Grok Build CLI)がインストールされているかを表示 — 実行しない読み取り専用のPATHスキャン。外観 → 会社ロゴを表示(既定オフ)は各社のファビコンを自身のドメインから取得してスキャン表に表示します(サードパーティ不使用)。
2 つのタブ:
- API keys & runtime — ブラウザから親プロジェクトの
.envを 編集 (career-ops の Node スクリプトが起動時に読むのと同じファイル)。 このタブはプロバイダ別のモデルセレクタも提供します —ANTHROPIC_MODEL・GEMINI_MODELと並んでOPENAI_MODEL(OpenAI/Codex)。 - Profile —
config/profile.ymlの直接 YAML エディタ。Save 時に 正規の# Career-Ops Profile Configurationヘッダを刻印します。
どちらのタブでも、保存は即時に反映されます — サーバ再起動は不要です。
LLM プロバイダのセットアップ(ステップバイステップ)。 web UI の ⚡ ライブ評価はヘッドレスで実行され、1 つの API キーを使用します。“OR” で動作します — これらのいずれか 1 つを設定すればそれだけで動作し、複数設定した場合は auto がこの順で優先します:Anthropic → Gemini → OpenAI → Qwen → OpenRouter → GitHub Models → Hermes → DeepSeek → GLM (Z.ai) → Kimi (Moonshot) → MiniMax → Mistral → Grok (xAI) → Together → Fireworks → Ollama → BytePlus Ark → Volcengine Ark。(career-ops 自体は CLI 非依存です — Claude Code、Cursor、Codex、Gemini、OpenCode、Antigravity、Grok Build、Qwen、Copilot または Kimi の中でも実行でき、それはこのヘッドレスキーとは別です。)
#/config→ API keys & runtime タブを開きます。LLM_PROVIDERでプロバイダを選びます:auto(設定されているキーを使用)、またはclaude/gemini/openai/qwenで 1 つに固定。- 選んだプロバイダのキー + モデルを入力します:
- Anthropic —
ANTHROPIC_API_KEY(console.anthropic.com)を設定、任意でANTHROPIC_MODEL(既定claude-sonnet-4-6)。 - Gemini —
GEMINI_API_KEY(aistudio.google.com/apikey)を設定、任意でGEMINI_MODEL(既定gemini-3.6-flash)。 - OpenAI —
OPENAI_API_KEY(platform.openai.com)を設定、任意でOPENAI_MODEL(既定gpt-5-codex)。 - Qwen —
QWEN_API_KEY(Alibaba Model Studio / DashScope、dashscope.console.aliyun.com)を設定、任意でQWEN_MODEL(既定qwen-max)。中国本土エンドポイントは raw.envでQWEN_BASE_URLを設定します。
- Anthropic —
- 保存 をクリックします。キーは親プロジェクトの
.envに書き込まれます;変更は即時に反映されます — サーバ再起動は不要です。 #/evaluateで検証します:求人の URL/説明を貼り付けて ⚡ ライブ実行 を押します。結果ヘッダにどのプロバイダが実行されたか(anthropic/gemini/openai/qwen)が表示されます。どこにもキーが設定されていない場合 → 代わりにコピー&ペーストの手動プロンプトが得られます。
シークレットは保存後にマスクされ、決してログ出力されません。モデル id フィールド(*_MODEL)はシークレットではありません。
Profile タブ
v1.32.0 — 項目別フォーム。 Profile タブは生 YAML の textarea ではなく、候補者 / ナラティブ / 報酬 の折りたたみセクションを持つフォームになりました。保存時はモデル化された 14 のスカラーパスのみ送信し、サーバが
config/profile.ymlに マージ するため、archetypes・proof_points・独自キーは そのまま保持 されます。トレードオフ: 項目保存は YAML を再シリアライズするため#コメントは失われます — 保持や入れ子配列の編集にはタブ下部の Advanced: edit raw YAML を使用してください。 v1.35.0 — 配列エディタ。 Target roles・Superpowers(文字列リスト)、Archetypes(name/level/fit)、Proof points(name/url/hero-metric)の add/remove エディタを追加。merge-not-replace は同一保証;リストを空にするとキーがクリーンに削除されます。 v1.54.3 — Modes タブの構造化フォーム。modes/_profile.mdはセクション別の生 markdown エディタではなくなり、文書化されたスキーマから派生したフィールドフォームになりました。リスト型セクション — Target Roles / Adaptive Framing / Comp Targets — は繰り返し可能な行項目入力(行の追加/削除)、散文セクション — Exit Narrative / Location Policy — はラベル付き textarea としてレンダリングされ、未知または非リストのセクションはラベル付きの逐語 textarea にフォールバックします。保存は 依然としてセクション単位でマージ — プリアンブル・未編集セクション・カスタムセクションをバイト単位で保持。ファイル全体の編集(セクション追加/削除・プリアンブル編集)用の Advanced: raw markdown はそのまま残ります。
- テキストエリアには現在の
config/profile.ymlがそのまま表示 されます。 - 編集して 💾 Save をクリック。サーバが YAML を検証し
(マッピングであること、
candidateを含むこと) ファイルに 書き込みます。 - 不足していれば
# Career-Ops Profile Configurationヘッダが 追加されます。 #/profileの読み取り専用サマリは視覚的なコンパニオンです。
認識されるキー
よく必要になるキーです。これは登録簿ではなく抜粋で、認識されるキーの全一覧はグループ分けとヒント付きで #/config にあります。
| キー | 動作 | 取得元 |
|---|---|---|
ANTHROPIC_API_KEY |
Anthropic SDK へのライブコールを有効化。Anthropic と Gemini が両方設定されている場合に優先 — JD 採点と深掘りリサーチでの長文構造化出力の品質が高い。 | https://console.anthropic.com/settings/keys |
ANTHROPIC_MODEL |
デフォルトの claude-sonnet-4-6 を上書き。難しい推論には claude-opus-4-7、安価で高速な用途には claude-haiku-4-5-20251001 を試してください。 |
— |
GEMINI_API_KEY |
Anthropic キーがない場合のフォールバック。gemini-eval.mjs が oferta モードで使用。少量なら無料ティアで動作。 |
https://aistudio.google.com/apikey |
GEMINI_MODEL |
デフォルトの Gemini モデルを上書き。 | — |
PORT |
Express のバインドポート。デフォルト 4317。 | — |
HOST |
バインドアドレス。デフォルト 127.0.0.1。0.0.0.0 を設定すると UI が LAN に公開されます — まだ認証ゲートはありません。Production-readiness ドキュメントを参照してください。 |
— |
動作
- 読取り (
GET /api/config) はすべての認識キーを返します。 シークレットキー (ANTHROPIC_API_KEY、GEMINI_API_KEY) は マスクされます —sk-ant•••••••a1b2のように見え、完全な値は 決して表示されません。 - 保存 (
POST /api/config) は各値を検証し、<parent>/.envに 書き込み、実行中のプロセスに即時適用します。再起動不要。 - 空値で削除 されます——設定は未設定に戻り、プロジェクトの既定値が再び効きます。
- ドロップダウンは「既定値を使う(…)」から始まります。 これを選ぶと、そのキーは
.envに書かれません。アプリはプロジェクトの既定値を使い、プロジェクトが既定値を変えれば新しい値が届き続けます。同じ値を下の一覧から選ぶと固定され、既定値が動いても残ります。 - 触れていない欄は書き込まれません。 未設定の欄はサーバーが使う値を見せるために既定値を表示しますが、実際に編集しない限りその表示値は保存されません。
- 保存は変更内容を報告します。 トーストは書き込んだキーと削除したキーの両方を数えるので、欄を空にすると「· 0」ではなく「· 1」と出ます。
スモークテストボタン
保存後、▶ Test Anthropic または ▶ Test Gemini をクリック すると、いずれも小さなプロンプト (出力 ≤256 トークン) を発射し、 ほとんどコストをかけずにキーの結線を確認できます。成功時は約 200 字の サンプルが返ります。
セットアップドクター — 未完成の CV・プロフィールを見つける
#/config の セットアップドクター タブは、cv.md と config/profile.yml が実際に埋まっているかを読み取り専用で点検し、プロンプトファイル(modes/_shared.md、modes/_writing.md、batch/batch-prompt.md)に残った例・プレースホルダーのデータやハードコードされた数値があれば警告します。結果を エラー(パイプラインに必要なものが欠けている。例:cv.md がない)と 警告(例データが残っている、短すぎる CV、怪しい数値)に分けます。何も書き込まず、どこにも送信しません — 読んで報告するだけです。これらのファイルを編集したら 再チェック を押してください。親プロジェクトのない単独インストールでは、代わりに淡色の「利用不可」行が表示されます。
3. プロフィール (#/profile — #/settings でも到達可能)
config/profile.yml の読み取り専用サマリカードビューです。
編集には App settings → Profile タブ (#/config → Profile)
へ移動してください。Save は同じファイルに書き込まれ、このページは
リロード時に再パースします。
特に重要なフィールド:
candidate.full_name— すべてのプロンプトで使用されます。 実運用前に テンプレートのJane Smithを必ず置き換えて ください。さもないと生成されるカバーレターがプレースホルダ名で 送信されてしまいます。candidate.email、linkedin、github— カバーレター生成と apply チェックリストで参照されます。target.roles— 受け入れる職種タイトル。スキャナーのポジティブ フィルタが暗黙にこれを利用します (portals.yml::title_filter経由)。target.comp_total_min_usd— 最低総報酬。各評価のセクション D で これを下回るオファーがフラグされます。target.archetypes— 最も重要なフィールド。これらは受け入れる キャリアパターン (例:Tech-Lead-Backend、Founding-Engineer、Data-Platform) です。各 JD はこれらに照合され、最適な archetype が レポートヘッダに記載されます。
Health ページは Profile customized チェックを表示し、
full_name が既知のプレースホルダ名と一致する限り失敗します。
4. 履歴書 (#/cv)
すべての評価、深掘りリサーチ、カバーレターの唯一の真実源です。
親プロジェクトルートの cv.md に保存されます。
編集オプション
- 直接貼り付け — 左のテキストエリアは markdown エディタです。 右ペインは LLM (および将来のリクルータ) が見る内容を反映します。
- 📁 Upload CV — 以下のいずれかの形式のローカルファイルを選択
すると、サーバが markdown に変換します:
- テキスト形式 —
.md、.markdown、.txt、.html、.htmはそのままパススルー (HTML は pandoc → GFM markdown)。 - Office 形式 —
.docx、.odt、.rtfは pandoc で変換 (macOS はbrew install pandoc、Linux はapt install pandoc)。 - PDF —
.pdfは Poppler の pdftotext で抽出 (brew install poppler/apt install poppler-utils)。 - 変換された markdown がエディタに挿入されます。💾 Save を クリックして永続化します。結果はサニタイズされます (貼り付けと同じ XSS 除去)。
- ハード上限: アップロードあたり 10 MB。それ以上は 413 で 拒否されます。
- テキスト形式 —
- LinkedIn から — 最も簡単な経路: 親プロジェクトで Claude Code
を開き
/career-opsを実行、LinkedIn URL を貼り付けてextract my CV from this and write it to cv.mdと依頼します。
サニタイズ対象
サーバ側で、/api/cv への各 PUT は stripDangerousMarkdown を
通過します:
<script>、<iframe>、<object>、<embed>、<svg>、<style>、<form>タグ — すべて完全に除去。- インラインイベントハンドラ (
onclick=、onerror=など) — 除去。 javascript:、vbscript:、data:text/htmlの URI スキーム — 無害化。
上記のいずれかが除去された場合、レスポンスには sanitized: true が
含まれ、ソースに危険な要素があったことを把握できます。
最大ボディサイズ: 1 MB。それ以上は 413 を返します。
その他のボタン
- sync-check — 親プロジェクトで
cv-sync-check.mjsを実行 します。不整合をフラグ: CV に記載されているプロジェクトがdata/applications.mdの archetypes にない、など。 - 📄 PDF を生成 —
generate-pdf.mjsをストリーミングで 実行します。出力先はoutput/*.pdf。Playwright が必要です (Health ページが親のnode_modulesでインストール済みかを 表示します)。生成完了時に 最新の PDF がデフォルトの Downloads フォルダへ自動ダウンロードされ、ページ上のリストは 過去に生成されたファイルもすべて保持します。
トーン / フォーマットのコツ
- 箇条書き 1 つ = メトリクス付きの実績 1 つ。 “Reduced p99 latency by 38%” は “improved performance” より あらゆる評価ルーブリックで優位です。
- セクション順: Summary (3–5 行)、Experience (新→旧の逆時系列)、Projects (最大 5)、Education、 Skills (重複排除、バズワードの羅列禁止)。
- 1500 ワード以内に抑えてください。採点ルーブリックは情報密度を 重視し、冗長な CV はノイズとしてペナルティを受けます。
5. ポータルとソース (portals.yml)
スキャナー設定は親ルートの portals.yml にあります。重要な
セクションは 3 つです。SPA の 3 セクション (下記) は
scan-job-portals
の正規スキーマと 1:1 で対応します。
ショートカット:
#/portalsURL は App settings に直接 解決されるようになり、(地域ソースが設定されている場合は) Regional sources グループへジャンプします — ブックマークや 手入力した#/portalsリンクはもう 404 になりません (v1.42.0)。
title_filter
title_filter:
  positive: [backend, engineer, senior, tech lead, golang, php]
  negative: [junior, intern, frontend, ios, android, java]
  seniority_boost: [Senior, Staff, Lead, Principal]
スキャンされた求人は、タイトルに 少なくとも 1 つのポジティブ キーワードを含み、かつ ネガティブキーワードを 1 つも含まない 場合に通過します。両方を調整してください。キーワードは大文字小文字を 区別しない部分文字列です。
seniority_boost は 3 つ目のタイトルフィルタキーです。ここに
列挙されたキーワードは何もフィルタしませんが — マッチした求人を結果の
上位に押し上げ、“Senior Backend Engineer” が “Engineer” より上に
来るようにします。デフォルト: ["Senior", "Staff", "Lead"]。
ターゲットロールのタイトル付けに合わせて調整してください。
明確化のため、最初は 3–5 個のポジティブキーワードで始め、後で広げます。
content_filter(任意 — web-ui 1.75.0, parent #974)。 location_filter
のトップレベルの兄弟キーで、同じ positive / negative キーワードリストを
持ちますが、勤務地ではなく求人の 説明 / スニペット テキストに対して
マッチします:
content_filter:
  positive: ["python", "machine learning"]
  negative: ["security clearance", "on-site only"]
location_filter と同じセマンティクス: キーなし → すべて通過。説明が
空 / 欠落 の求人は通過(欠落データはペナルティなし)。negative 一致 →
拒否。positive が空 → 通過。positive が非空 → 少なくとも 1 つのキーワードに
一致が必要(大文字小文字を区別しない部分文字列)。ATS スイープとリージョナル
スイープの両方で適用されます。説明 / スニペットを提供するソース(例: RSS)
のみが影響を受け — それ以外の求人はすべて通過 — 本文を持たないソースの行が
有効化により黙って落とされることはありません。タイトルは通過したが本文に
決定的な問題が現れる求人を落とすのに使います。
location_filter (任意 — web-ui 1.33.0, parent #570)
location_filter:
  allow:
    - "Remote"
    - "United States"
    - "Atlanta"
  block:
    - "India"
    - "London"
    - "Germany"
スキャンした求人を 勤務地 文字列(大文字小文字を区別しない部分一致)でフィルタし、ATS スイープと地域スイープの両方に適用されます。正規の career-ops scan.mjs と同一のセマンティクス:
location_filterなし → すべての勤務地が通過(既定)。- 勤務地が空/欠落 → 通過(欠損データは不利にしない)。
block一致 → 却下(block が allow より優先)。always_allowの一致 → 通過。blockの一致があっても優先されます — 複数国のロケーション文字列のための逃げ道です(v1.248.1)。block_hardの一致 → 拒否。always_allowはこれを上書きできません。allow空 → 通過(block で既に除去済み)。allow非空 → 少なくとも 1 つ のキーワードに一致が必要。
portals.yml のトップレベルキー(title_filter の兄弟、russian_portals の下ではない)。
years_min (任意 — web-ui 1.262.0)
years_min: 3説明文にあなたの基準を下回る最低経験年数が明記された求人をスキップします。パーサーが読むのは明記された要件のみ — 数字の明記がない求人は常に通過します(推測で落とすことはありません)。スキップされた行は data/scan-history.tsv に skipped_experience として記録されます。これは観測用のステータスで URL を固定しないため、求人は後のスキャンで再び現れます。
search_queries
search_queries:
  - name: "Greenhouse — Rails Engineer"
    query: 'site:job-boards.greenhouse.io "Rails Engineer" OR "Ruby on Rails" remote'
    enabled: true
  - name: "Ashby — Senior Backend"
    query: 'site:jobs.ashbyhq.com "Senior Backend" remote'
    enabled: false
search_queries は AI 駆動の Option B スキャン (/career-ops scan を
Claude Code / Cursor / Codex 内で実行) を駆動します。インプロセスの
npm run scan (パブリックなボード API のみを叩く) では実行
されません。tracked_companies にまだ含まれていない企業の
ロールを発見したいときに使います。enabled: false でエントリを
削除せずに実行を停止できます。
tracked_companies
tracked_companies:
  - { name: Stripe,     enabled: true, careers_url: https://job-boards.greenhouse.io/stripe }
  - { name: Linear,     enabled: true, careers_url: https://jobs.ashbyhq.com/linear }
  - { name: JetBrains,  enabled: true, careers_url: https://jobs.lever.co/jetbrains }
エントリごとの必須フィールド: name と careers_url。任意:
api (明示的な Greenhouse / Ashby / Lever / Workable /
SmartRecruiters / Workday のエンドポイント)、enabled: true|false
で削除せずに含める/除外する。ATS スキャナーは URL パターン
(job-boards.greenhouse.io/<slug> → Greenhouse など) から ATS を
検出し、各社のパブリック boards-api を直接取得します。認識可能な
ATS を持たない企業はスキップされます (/#/scan の Active
Companies カードがグレー ○ で表示します)。
Personio テナントの固定 (v1.237.0)。 多くの企業は自社ブランドの
採用ページに Personio ボードを iframe として埋め込むため、
careers_url は自社ドメインを指す一方で、実際のフィードは
<slug>.jobs.personio.de にあります。固定しないと、それらのボードは
何も解決しません。テナントの slug を明示的に指定すると、
careers_url より優先されます:
tracked_companies:
  - { name: Acme, enabled: true, provider: personio, personio: acme, careers_url: https://acme.com/careers }
slug は使用可能な文字が制限されており(英字・数字・ハイフンのみ、
ハイフンで始まらない、最大63文字)、生成される URL も同じホスト
allowlist と HTTPS チェックを通過します — ドット、スラッシュ、@、
: を含む slug は拒否され、そのエントリは careers_url に
フォールバックします。
タイトルに雇用形態を表示する (Jobstreet / SEEK、v1.237.0)。
appendWorkType でオプトインすると、求人の雇用形態がタイトルに
追加され、タイトルフィルタや triage がスキャン時点でそれを確認
できます。デフォルトではオフです:
tracked_companies:
  - name: Acme
    enabled: true
    provider: jobstreet
    jobstreet: { siteKey: AU-Main, appendWorkType: true }   # → "Strategy Consultant [Part time]"
siteKey は市場を選択します: ID-Main(id.jobstreet.com)、
SG-Main、MY-Main、HK-Main(hk.jobsdb.com)、
AU-Main(au.seek.com, www.seek.com.au)、`NZ-Main`(nz.seek.com, www.seek.co.nz)。求人リンクは
市場ごとに構築されます — /id/ ロケールプレフィックスを使うのは
インドネシアのホストだけなので、他の市場向けに構築したリンクに
これを付けると 404 になります(v1.237.0 で修正)。
rss (RSS / Atom boards)
tracked_companies:
  - { name: LaraJobs, enabled: true, provider: rss, rss: https://larajobs.com/feed }
  - { name: WeWorkRemotely, enabled: true, provider: rss, rss: https://weworkremotely.com/remote-jobs.rss }
RSS/Atom フィードを公開している任意の求人ボード(LaraJobs、WeWorkRemotely、RemoteOK、golangprojects など)に、provider: rss と rss:(または feed_url:)キーを持つエントリを追加するだけでスキャナーを向けられます — コード変更不要。RSS アダプターは各 <item> を解析し(CDATA + HTML エンティティ、タイトル/会社名はタグ除去)、求人に正規化し、ATS ソースと同じ title_filter / location_filter + 重複排除 + パイプライン追記のフローを実行します。その後 RSS は #/scan のフィルタードロップダウンに選択可能なソースとして表示されます。(web-ui v1.62.x)
telegram_channels(公開 Telegram 求人チャンネル)
telegram_channels:
  enabled: true
  max_posts: 100          # default cap per channel (hard cap 300)
  channels:
    - { name: "PHP jobs", channel: rabotaphp }
- { name: "Salary PM", channel: salary_pm, max_posts: 50 }公開の Telegram チャンネルは、ここに列挙するだけでスキャンできます —— ボットトークンも API キーも不要です。各チャンネルは公開ウェブプレビュー https://t.me/s/<チャンネル> から読み込まれます。これはサーバー生成の素の HTML です。channel: は書き方を問いません(rabotaphp、@rabotaphp、完全な t.me/… リンクのいずれでも可)。max_posts: は読み取る直近投稿数の上限です(既定 100、ハード上限 300)。チャンネルは tracked_companies ではなく専用のトップレベルブロックに置きます —— チャンネルは雇用主ではなく、検出すべき採用ページ URL を持たないからです。
チャンネルの投稿は散文であり、求人レコードではありません —— 構造化フィールドは存在しません。ソースは最初の実質的な行から見出しを取り、会社・勤務地・給与は明示ラベル(Компания:、Локация:)からのみ読み、本文はそのまま説明に残します。本物の求人を広告やダイジェストから分けるのは、あなたの title_filter の仕事です。非公開・存在しないチャンネルは「求人なし」ではなくエラーとして報告されます。その後 Telegram が #/scan のフィルターに選択可能なソースとして現れます。(web-ui v1.228.0)
russian_portals
russian_portals:
  sources: ["hh", "habr", "trudvsem", "getmatch", "geekjob"]      # またはいずれか一方
  area: 113                 # 1=モスクワ、2=サンクトペテルブルク、113=ロシア、1001=リモート
  per_page: 50
  only_remote: false
  queries:
    - "Senior PHP"
    - "Senior Go"
    - "Тимлид PHP"
queries は hh.ru と Habr Career の求人タイトルに対する大文字小文字
非依存の部分文字列マッチです。ネガティブリストとの重複に注意して
ください — "Senior PHP" が queries にあり、"php" が
title_filter.negative にある場合、スキャンは結果ゼロになり、
コンソールに競合状態の警告が出ます。
ロシア系ポータルの構成 — 詳細セットアップガイド
v1.29.0 は 5 つのロシア向けアダプタを同梱しています。2 つはデフォルト UA 以上の設定不要(habr-career HTML スクレイプ、trudvsem 政府オープンデータ API — キーなし、地域制限なし)。2 つはテック系ポータルの HTML スクレイプ(getmatch、geekjob — キーなし)。1 つは hh.ru 標準 API で、ロシア国外 IP からは App settings → API keys & runtime で HH_USER_AGENT を設定しないと 403 を返す可能性があります(あるいはロシア IP / VPN を経由)。
ソース一覧
| キー | 表示名 | タイプ | 認証 | 地域制限 |
|---|---|---|---|---|
hh |
hh.ru | JSON API | 任意 HH_USER_AGENT |
RU 外 IP は 403 の可能性 |
habr |
Habr Career | HTML | なし | なし |
trudvsem |
Trudvsem | JSON API(オープンデータ) | なし | なし |
getmatch |
GetMatch | HTML | なし | なし |
geekjob |
GeekJob | HTML | なし | なし |
ステップ 1 — portals.yml を開く
ファイルは親プロジェクト career-ops/ のルートに存在します(web-ui/ の中ではない)。まだ無い場合は、親プロジェクト同梱のテンプレートをコピーしてください:
# from the parent career-ops/ root (NOT web-ui/)
cp templates/portals.example.yml portals.yml
$EDITOR portals.yml
ステップ 2 — 5 ソースを有効化
russian_portals ブロックを追加/更新し、スキャンしたい全ソースをリストします。配列順は問いません — スキャナはレジストリ順に呼び出します。
russian_portals:
  sources: ["hh", "habr", "trudvsem", "getmatch", "geekjob"]
  area: 113                  # 1=Moscow, 2=SPb, 113=Russia, 1001=remote
  per_page: 50               # how many vacancies per query per source
  only_remote: false         # set true to keep only remote postings
  queries:
    - "Senior PHP"
    - "Senior Go"
    - "Backend Senior"
    - "Тимлид PHP"
ステップ 3 — クエリとフィルタの調整
queries は、スキャナが各ソースに対して検索する文字列です。各クエリはソースごとに 1 回実行されます — 4 クエリ × 5 ソース = 1 スキャン 20 回呼び出し。スキャン時間を 1 分以内に保つため、リストは 3–7 個に絞ってください。area は hh.ru のリージョンコード(他ソースは無視)。per_page はクエリあたりの返却件数上限。only_remote: true はアダプタレベルでリモートのみフィルタ(結果テーブルにも別途 Remote チップあり)。
よくある落とし穴
Negative リスト衝突。 クエリ内の単語("php"、"senior")が title_filter.negative にもある場合、表示前に全結果がフィルタされます。スキャナはスキャン時に stderr 警告を出します — ⚠ config: query "Senior PHP" contains "php" which is in the negative list の行を 探してください。negative から該当語を外して解決します:
title_filter:
  positive: [backend, senior, lead, php, go, golang, python]
  negative: [junior, intern, frontend, ios, android]
russian_portals:
  queries:
    - "Senior PHP"     # OK — "php" no longer in negative list
    - "Senior Go"
1 ソースを一時的に無効化する
データを削除せずソースを無効化するには、sources から該当キーを外すだけです:
russian_portals:
  sources: ["hh", "habr", "trudvsem"]   # only 3 of 5 sources will run
設定の確認
portals.yml を保存後:
# 1. Save portals.yml.
# 2. In the SPA, switch to #/scan.
# 3. Click 🌐 Scan now.
# 4. Watch the SSE log for the per-source line per query:
#       "Senior PHP"
#         hh.ru    18
#         habr     21
#         trudvsem  3
#         getmatch  0
#         geekjob   2
#    A value of 0 is normal for some queries — it just means that
#    source had no matches. A "geo-blocked" or "timeout" line means
#    the adapter reached the site but couldn't read results.
CLI ブートストラップフロー (scan-job-portals)
正規の career-ops セットアップ (親ルートで一度だけ実行):
cp templates/portals.example.yml portals.yml
$EDITOR portals.yml
これがブートストラップのすべてです。3 つのセクション
(title_filter、tracked_companies、search_queries、任意で
russian_portals) を編集し、保存すれば、スキャン準備完了です。
SPA のブートストラップ動作
初回起動時、portals.yml に存在しなければサーバはドキュメント済みの
russian_portals: ブロックを追記します — 冪等です (2 回目の起動は
文字列 russian_portals: が既にあるため no-op)。英語圏セクションは
自動注入されません。上記の正規ブートストラップに従って
templates/portals.example.yml をコピーして取得します。
会社の ATS 求人ボードを見つける
#/portals の上部に ATS ボードを検出 ボックスがあります。会社名(例:「Stripe」)を入力すると、アプリが Greenhouse・Ashby・Lever でその名前の公開求人ボードを探索します — 読み取り専用、AI なし、ブラウザなし。ボードがあり かつ 現在少なくとも 1 件の求人を掲載している各ベンダーごとに、ベンダー・採用 URL・掲載求人数を示すマッチが得られます。追跡に追加 を押すと、そのボードが portals.yml の tracked_companies: に追記され、次回のスキャンからスキャナーがその会社を見張り始めます。重複は検出され(「追跡済み」と表示)、既知の ATS ホストのみ追加できます — 任意の URL は拒否されます。探索するのは Greenhouse・Ashby・Lever のみで、別ポータルの会社や今求人が出ていない会社はマッチしません。
6. ヘルス (#/health)
すべてのセットアップゲートを OK / OPTIONAL / FAIL バッジで表示 します。「動かない」issue を立てる前にこのページを読んでください。
AI使用量とコスト。 AI使用量ページ(💳、ヘルスの隣)はライブAI生成のトークンをプロバイダーごとに24時間/7日/30日/全期間で表示し、編集可能な価格表からの推定USDコストを併記します(請求なし)。 コンパクトな使用量メーターも、すべてのページで左サイドバーの下部に固定されます — 同じ24h/7d/30dのトークン合計と24時間の推定コストがライブ更新され、メニューは常にその上に隠れず表示され、ヘッダーをクリックすると折りたためます。
必須チェック (これらなしではシステムは機能しません)
Node version≥ 18 — サーバはネイティブのfetchとnode:testを使用します。Project root—CAREER_OPS_ROOT(環境変数または自動検出) が 存在すること。cv.md、config/profile.yml、portals.yml、data/applications.md、data/pipeline.md、modes/oferta.md。
任意チェック (警告のみ)
Profile customized—candidate.full_nameがテンプレート プレースホルダではないこと。GEMINI_API_KEY/ANTHROPIC_API_KEY—.envに設定済み。 場合のみ重要。Playwright (parent node_modules)— PDF 生成とcheck-liveness.mjsに必要。cd $CAREER_OPS_ROOT && npm install && npx playwright install chromiumでインストール。Parent project dependencies— 不足していればcd $CAREER_OPS_ROOT && npm install。data/、reports/、output/、jds/ディレクトリ — 初回書込み時に 自動作成。
サーバがループバック外に公開されている場合 (HOST=0.0.0.0)、
レスポンス中の絶対パスと正確な Node バージョンは "hidden" に
置き換えられ、好奇心旺盛な隣人があなたのインストールをフィンガープリント
できないようにします。
実行ボタン
- doctor を実行 は
node doctor.mjsを実行し、モーダルに出力を 表示します。 - ▶ Verify pipeline は
node verify-pipeline.mjsを実行します。
7. 検索 (#/scan)
スキャナーは有効化されたすべてのボードをクロールし、履歴に対して
重複排除し、ヒットを data/last-scan.json と data/pipeline.md に
書き出します。
ワンクリックスキャン (SPA)
🌐 スキャン はすべての有効ソースを 1 回のスイープで実行します:
- Greenhouse / Ashby / Lever / Workable / SmartRecruiters / Workday
(ATS スイープ) を、認識可能な ATS URL を持つ
tracked_companiesのすべての企業に対して実行。 - v1.75.0 のアグリゲーターを、いずれかにオプトインしている
tracked_companiesの各エントリに対して実行: RemoteOK / Remotive / Working Nomads(ボード全体のリモートフィード、provider: <slug>)および IBM / Arbeitsagentur / Glints / Jobstreet · SEEK(設定駆動、エントリごとの<provider>:ブロック)。 - hh.ru API + Habr Career + Trudvsem + GetMatch + GeekJob を、
russian_portalsの各クエリに 対して実行。
1 クリックで 2 フェーズ(v1.29.2)。 単一の 🌐 スキャン ボタンが ATS スイープと地域スイープの両方を、1 つの SSE ストリーム上で実行します。ログには 2 つのフェーズ見出しが順番に現れます:
▶ ATS scan (Greenhouse + Ashby + Lever)— EN ATS ボード。▶ Regional scan (hh.ru + Habr Career)— レジストリの 5 つの RU ソース。
各フェーズは ✓ done · NEW=N のサマリで終わります。ATS フェーズしか見えない場合、stand は v1.29.2 より前のビルドです — アップグレードしてください。v1.29.2 より前は SSE クライアントが最初の done でクローズし、地域フェーズが静かに失われていました。
ライブ SSE ログがスキャン中に右ペインへストリーム表示されます。
停止 をクリック (または単に離脱) すると中断します — サーバは
AbortController 経由で進行中の HTTPS リクエストをキャンセルします。
結果のフィルタリング
ログの下、結果テーブルは data/last-scan.json の行をレンダリング
します。テーブルの読み込み中(および再読込のたび)には、白紙のペインの
代わりにグレーのシマー状の行が表示され、ページタイトルは最初の
フレームからそこにあります — 遅いスキャンが死んだページに見えることは
ありません。
v2 の結果表示はコントロールを見つけやすく保ちます:
- 適用中のフィルター (
scan.v2.activeFilters) — 設定した フィルターはすべて、テーブルの上に削除可能なチップとして現れます。 チップの ✕(フィルターを解除、scan.v2.removeFilter)を クリックすればその 1 つだけを外し、すべてリセット (scan.v2.resetAll)で一括クリアします。 - 並べ替え (
scan.v2.sortBy) — 列見出し(会社、役職、給与、 経過日数)をクリックするとその列で並び、もう 1 度クリックすると 向きが反転します。 - クイック表示 (
scan.v2.quickView) — 行をクリックすると、 ページを離れずに求人説明(説明、scan.v2.description)が その場で展開されます。本文を取り込んでいない求人は、白紙のカードを 見せる代わりにその旨を表示します(scan.v2.noDescription)。 - ログ (
scan.v2.log) — ストリーミング中のスキャンログを 折りたたみ/展開して、テーブルに全幅を譲ります。
各行は固有のアクションを備えます:評価(scan.v2.evaluate)は
その求人の採点付き評価へ直行し、パイプラインへ
(scan.v2.toPipeline)は URL をキューに入れ(すでにキュー済みなら
トーストを出します、scan.v2.pipelineDup)、求人を開く ↗
(scan.v2.openPosting)は採用ページを新規タブで開き、☆ スターは
お気に入りを切り替えます。
検索 + 除外。 検索 ボックスは「探したい役職」フィルターです —
1 つ以上の語を カンマ区切り で入力すると、いずれか 1 つ にでも
一致した行が表示されます(OR)。先頭に -語 を付けるとその語を
除外 します(scan.v2.moreHint)。別にある 除外
(scan.lblExclude)ボックスは語丸ごとに対して同じことをします:
カンマ区切りの語に一致して 会社 / 役職 / 勤務地 を含む行を
非表示 にします(例:senior, staff, java を除外)。どちらも
保存済み検索に記憶され、リモート / ソース / 国 / 経過日数 / 給与の
フィルターと並んで扱われます。
v1.78.1 — ライブ自動更新。 結果テーブルは、スキャンの実行中に 自動で更新され、終了直後にもう一度更新されます — 手動でのリロード やページ切り替えは不要です。
v1.80.0 — Max per source とソースの隔離(quarantine)。 Scan ボタンの 隣にある Max per source フィールドは、各ボードが提供する求人件数の上限を 設定します(空 / 0 = 無制限、既定値) — 1 つの巨大なボードが結果を独占して しまう場合に便利です。これとは別に、恒久的な 404 / 410 を返すソースは
data/scan-quarantine.jsonに記録され、以降のスキャンではスキップされます (自己回復:14 日後に再試行)。これにより、死んだ slug がログを汚し続けるのを 防ぎます。portals.ymlでscan_quarantine: falseを指定すると無効化できます。
フィルタ(常時表示:検索、除外、勤務形態、ソース、国;それ以外は
すべて 詳細フィルター(scan.advancedFilters)の後ろにあり、
パネル全体は 結果フィルタ(scan.filtersGroup)の下にグループ化
されます):
- フリーテキスト — タイトル / 会社名に対する部分一致。
- Source ドロップダウン — レジストリが知るすべてのソース
(現在 123:118 EN + 5 RU、既定は All sources)。
GET /api/scan/sourcesからライブで自動構築されるため、新しく 追加されたアダプタはアプリの変更なしでここに現れます — リストが ハードコードされることはありません。 - Remote / Hybrid / Onsite ドロップダウン。
- Country ドロップダウン — 現在の結果から検出された国で構成される地理フィルターで、各項目は国旗絵文字と件数とともに表示されます(例:
🇩🇪 Germany (12))。1 つを選ぶと、その国に紐づく求人だけが残ります。検出は求人の自由記述の勤務地(国名/別名 + ~100 の主要求人市場都市)を国にマッピングします。保守的で決して推測しないため、勤務地を解決できない求人 — または純粋な「Remote」掲載 — は All countries の下に残ります。勤務形態ドロップダウンと組み合わせれば、国に紐づく求人とリモート求人の両方を見つけられます。 - Posted within ドロップダウン — クライアント側の経過時間フィルター(Last 24 hours / 7 days / 30 days)。
pubDateがそれより古い行は非表示になります。日付が記載されていない行は通過します(データの欠落はペナルティになりません)。 - 給与 下限 / 給与 上限 (
scan.salaryFrom/scan.salaryTo) — 求人本文から抽出した金額と比較される単純な数値の下限・上限です(通貨は無視、scan.v2.salaryHint)。給与のない求人を含める(scan.v2.includeNoSalary)にチェックを入れると、金額を 1 つも記載しない行が給与フィルターで落ちなくなります。 - レベル (
scan.lblSeniority) ドロップダウン — Lead / Staff / Senior / Mid / Junior / Intern。タイトルから検出されます。 - ★ お気に入り — 任意の行の ☆ をクリックすると求人にスターを付けられます(URL ごとに
localStorageに保存)。フィルターパネルの ★ お気に入り(scan.favOnly)にチェックを入れると、スター付きの行だけが表示されます。スターはスキャンやリロードをまたいで保持されます。 - 保存した検索 (
scan.savedSearches) — 現在のフィルターセットに名前を付けて 検索を保存(scan.saveSearch)すると、リストから再適用できます。保存した検索は 1 クリックで読み込まれ(scan.v2.loadSearch)、削除時には確認が入ります(scan.v2.deleteSearchConfirm)。localStorageに保存され、破損したり編集された値はクリーンに空へリセットされます。 - スタックチップ (PHP / Go / Backend / Senior / …) — 行ごとに
Skills.detectTechとSkills.detectLevelで自動検出。複数選択は 積集合 —PHP + Seniorを選択すると両方を持つ行が表示されます。 - 動的チップ (静的スタックチップの下) — タイトルから抽出した 頻出大文字トークンの上位 25。バックエンドエンジニア向けの語彙に 固定されず、実際にスキャンするロール (マーケティング、デザイン、 ファイナンス…) に UI が適応します。
Active Companies カード
portals.yml のすべての企業を要約する折り畳み可能なカードです。
見出しは アクティブな会社(scan.activeCo)で、ライブの N/M
カウンタが付きます — N は直近のスキャンで実際に結果を出した企業数、
M は現在有効な API 対応企業数で、両方の数字が常に同じ母集団を
表します(ロシア系ボードだけの実行で、分子が ATS 分母を超えて
膨らむことはありません)。ツールチップも同じことを平易な言葉で
述べています(scan.activeCo.help)。リストは 2 つのグループに
分かれます:
- ✓ 直接 API(
scan.apiBacked)— ボードを公開 ATS API から 直接取得します(118 個の EN アダプタのいずれか。Greenhouse / Ashby / Lever / Workable / SmartRecruiters / Workday から長尾 まで)。 - ○ Web 検索のみ(
scan.websearchBacked)— URL に一致する アダプタがなく、代わりに CLI の AI スキャンがカバーします。
会社名クリック → 上の結果フィルタにその名前を入れる。
↗ アイコンクリック → 会社の careers_url を新規タブで開く。
CLI スキャンフロー (scan-job-portals)
CLI 側からスキャンする方法は 2 つあります (どちらも SPA が読むのと
同じ data/pipeline.md に URL を投入します):
Option A — ダイレクトスクリプト (約 30 秒、AI トークンゼロ):
npm run scan                          # すべての Greenhouse/Ashby/Lever ボード
npm run scan -- --dry-run             # 永続化せずプレビュー
npm run scan -- --company Anthropic   # 1 社の tracked company に絞る
Greenhouse / Ashby / Lever / Workable / SmartRecruiters / Workday (認識可能な ATS URL) でのみ動作します。AI トークン消費なし — パブリックボード API を直接叩きます。
Option B — AI 駆動のブラウザスキャン:
/career-ops scanClaude Code / Cursor / Codex / OpenCode / Antigravity CLI / Grok Build CLI / Qwen Code / Kimi / GitHub Copilot CLI (Gemini CLI legacy) 内で実行。モデルトークンを
使います。各 tracked_companies のページを直接訪問し、API のない
ボード (採用ページ、カスタム ATS、地域ポータル) も発見できます。
低速ですが広範囲。ATS スイープで結果ゼロでも、採用していると分かって
いるターゲットに対して有用です。
出力 (両経路共通) — 新規 JD URL が data/pipeline.md に追記され、
訪問済み URL は data/scan-history.tsv にログ (今後のすべての
スキャンで重複排除)、サマリ出力: スキャンした企業 · 発見した求人 ·
タイトルでフィルタされた件数 · 重複スキップ · 新規追加オファー。
Score 別のアクション閾値 (/career-ops pipeline が新規 URL を
バッチ採点した後に適用):
| Score | 推奨される次のステップ |
|---|---|
| ≥ 4.5 | /career-ops apply — 高フィット、即応募 |
| 4.0 – 4.4 | 応募、または /career-ops contacto でウォームイントロ |
| 3.5 – 3.9 | /career-ops deep — まず調査 |
| < 3.5 | 特別な個人的理由がなければスキップ |
SPA の #/dashboard と #/tracker は 4.0 以上の行をハイライト
するので、何も再実行することなくアクションを選べます。
フォローアップコマンド
採点後、正規のフォローアップは以下のとおりです:
/career-ops apply— ロールに合わせた回答で応募フォームを記入/career-ops contacto— LinkedIn / メールアウトリーチを下書き/career-ops deep— 会社 / ロールを深く調査/career-ops tracker— pipeline のステータスを表示
hh.ru — ウェブサイトから取得(2026 年 7 月以降はロシアの IP が必要)
hh.ru は Habr Career と同じく、公開検索サイト(hh.ru/search/vacancy)を読んでスキャンします — キーも設定も不要です。ただし 2026 年 7 月以降、hh.ru はロシア国外の IP に HTTP 451(地域的な法的ブロック)を返すため、スキャンはロシアの IP からのみ動作します — ロシア国内でサーバーを動かすか、ロシアの出口ノードを持つ VPN を使ってください。最初の 451(またはアンチボットの 403)を受けると、スキャナーはその実行の残りで hh.ru を無効化しログに明記するため、他のロシア系ソースは最後まで完了します。JSON API(api.hh.ru)は意図的に使いません: IP や User-Agent に関係なく、あらゆるプログラムクライアントに 403 forbidden を返すためです。
正しそうに見えるネットワークからでも、hh.ru は出口 IP を VPN/プロキシと判定し(データセンター/ホスティングの IP はすべて該当)、スキャンを /vpncheeck 中間ページ(「VPN мешает работе сайта」)へ 302 リダイレクトすることがあります。このページは求人 0 件の HTTP 200 を返します。スキャナーはこのリダイレクトを検出し、実行の残りの間 hh.ru を無効化してログに記録します。対処はネットワーク側です:トラフィックが本当に住宅用 IP から出ているか確認してください — ブラウザのトグルをオフにしてもシステム全体の VPN やプロキシは有効なままのことがよくあります(実際の出口 IP は api.ipify.org などで確認できます)。
8. パイプライン (#/pipeline)
評価待ち URL の受信箱です。data/pipeline.md に保存されます。
概要ストリップ。 上部のコンパクトなストリップがパイプラインを一目で表示 — 受信(pipe.ovInbox)の URL 数、追跡中(pipe.ovTracked)の行数、そしてトラッカーから取得した Applied / Responded / Interview / Offer の各件数。各チップは #/tracker へ直結し(ステータスチップは絞り込み済みで開きます)、トラッカーを読めない場合は受信数だけに縮みます。
URL の追加
3 通り:
- 入力欄に URL を入力 / 貼り付けて URL を追加(
pipe.add)をクリック。 - コマンドパレット を使います:Cmd/Ctrl+K(またはサイドバーの コマンドメニュー ボタン、
nav.v2.palette)で開き、任意のhttp(s)://…リンクを貼り付けると、パレットは オートパイプライン: {url}(nav.v2.evalUrl)を提示します — Enter でその URL に全チェーンを実行します。それ以外のテキストを 入力して Enter を押すと、その語句が事前入力された状態で#/scanへ移動します。 - スキャンを実行 (上記) — 新規ヒットは自動で pipeline に追加。
すべての URL はサーバ側で isValidJobUrl() を通ります。ループバック
(localhost、127.0.0.1)、file://、javascript:、IP リテラル、
テンプレート文字 (<、>、") を含む文字列はすべて 400 で
拒否されます (SSRF 対策)。
サーバサイドプレビューペイン
任意の pipeline 行をクリックすると、右にプレビューがロードされます。
ほとんどの ATS ボードは CORS ヘッダを送らないため、ブラウザは直接
取得できません。サーバがリクエストをプロキシし、<script> /
<style> / HTML タグを除去して、最大 8 KB のプレーンテキストを
返します。
プレビュープロキシはリダイレクトを手動で辿り、ホップごとに SSRF
検証 を実施します — 各 Location ヘッダは再度
isValidJobUrl() を通るので、敵対的なボードがあなたをループバック
/ プライベート IP / file:// へ跳ね返すことはできません。3 ホップ、
15 秒のタイムアウトでキャップされています (TOCTOU と再バインド攻撃
対策)。
行アクション
- ▶ (
pipe.evaluateBtn) — URL を事前入力した#/evaluate?url=…へジャンプ。 - ✕ —
data/pipeline.mdから URL を削除します(事前に確認が入ります、pipe.confirmDel)。
グループ表示、一括削除、損失のない undo。 スキャン後の大きな 受信箱を片付けるのが、このページの v2 の目玉です:
- グループ表示(
pipe.viewGrouped)/ コンパクトリスト (pipe.viewFlat)— ツールバーで、フラットなリストと企業別の グループボードを切り替えます。同じ雇用主の求人が 1 つの ディスクロージャの下に折りたたまれ(大きいグループ順)、1 つの うるさいボードが他を埋め立てることがなくなります。未知の企業は そのホストでグループ化されます — ただし共有 ATS ホスト (たとえばjobs.lever.co)が企業名を借りるのは、そのホスト上の 企業名つきエントリが すべて 一致するときだけです。 - 評価済みを非表示(
pipe.hideTracked)— 既定でオン。すでに トラッカー行がある求人はビュー(と一括選択)から外れ、新規の 作業だけに取り組めます。 - 選択(
pipe.selectOne)で任意の行を、表示中をすべて選択 (pipe.selectAllShown)でまとめて選べます — 選択は常に現在の フィルターに従い、見えない行には決して及びません。選択バーには 件数が表示され(pipe.selectedCount)、✕ 選択項目を削除 (N) (pipe.bulkRemove)と 選択した最初の項目を評価 (pipe.evaluateSelected)を提示します — 一括削除は行ごとではなく セット全体に対して 1 回だけ確認します。
何も誤って失われることはありません:削除 — 単一でも一括でも — は
必ず不透明な復元トークンを返し、ページ下部のバー(削除しました: N、
pipe.deleted)が 元に戻す(pipe.undo)/ 閉じる
(pipe.undoDismiss)を提示します。削除は最大 5 バッチまでスタックし
(最古のものから捨てられ)、元に戻す は最新のバッチのトークンを
POST /api/pipeline/restore に送ることで、元の行を正確に再挿入します
(チェックリストのメタデータも含めて — 何も再導出・再追加されません)
し、パイプラインに復元しました(pipe.undone)で確認します。
バーはページ自身のマークアップの外に置かれているため、再レンダリング
(ナビゲーションやクイック追加フロー)が未処理の undo を呑み込む
ことはありません。サーバがトークンを知らない場合(再起動)は、その
URL は失われるのではなく素朴な方法で再追加されます。
右上ボタン
- ⚡ 先頭を評価 (
pipe.evaluateAll) — キューの最初の URL を Evaluate ページで採点可能な状態で開きます(どの求人に実行を 使うか決める操作なので、事前に確認が入ります)。 - 求人検索 — さらに URL が欲しい場合にスキャナーへ戻ります。
9. 評価 (#/evaluate)
1 件の求人説明 (JD) を cv.md と config/profile.yml に対して
採点します。modes/oferta.md に従って構造化された A–G 評価と
0–5 score を返します。
入力
JD をテキストエリアに貼り付けるか、#/pipeline から ?url=<href>
付きで到達した場合 — ページが pipeline プレビューと同じ SSRF セーフな
プロキシを通して URL を取得し、テキストエリアに事前入力します。
💾 Save JD をクリックすると JD を jds/jd-<date>-<ts>.txt に
永続化します (監査証跡用)。API 呼び出しで save: true を渡しても
同じ効果が得られます。
フォールバックチェーン
- Anthropic —
ANTHROPIC_API_KEYが設定されている場合に優先。 サーバはプロンプトの前にcv.md、config/profile.yml、modes/_shared.md、modes/oferta.mdを<project_context>ブロックに束ねます (ファイル種類ごとの上限 — cv 64 KB、mode ファイル 128 KB、その他 32 KB — フルプロンプトは 256 KB のソフトキャップ)。グラウンディングされた markdown を 直接ページに返します。 - Gemini —
GEMINI_API_KEYのみが設定されている場合。 サーバが JD を一時ファイルとしてgemini-eval.mjsを spawn します。無料ティアモデル (gemini-3.6-flash) は通常の採点には 十分です。 - 手動 — キー未設定。ページは Claude Code、ChatGPT、または 他の任意の LLM に貼り付けられる完全な形のプロンプトを返します。
出力セクション (正規 career-ops.org A-F)
v1.15.0 リアラインメント。 ブロックレターは 正規 career-ops.org スキーマ と一致するようになりました。v1.15 以前のレポートは A–G (
C=Risks、F=Verdict、G=Legitimacy) を使っていました。 後方互換性のためそのまま描画しますが、新規レポートは以下の 正規セマンティクスで A–F を出力します。Score と Legitimacy は レポートヘッダに移動しました (score: 4.2/5、legitimacy: High|Medium|Low)。
A. Role Summary — 3 つの箇条書きで要約 (リスクはインラインで明示)。
B. CV Match — 上位 3 つの一致スキル + 上位 3 つの不足スキル。
C. Strategy — 推奨: 即応募 / 先に contacto / 先に deep /
スキップ。v1.15 以前は Risks でした。
D. Compensation — target.comp_total_min_usd (レガシー)
または compensation.target_range (正規) に対する相対評価。
E. Personalization — リードするアングル、archetype ごとの
フレーミング、カバーレター / アウトリーチで触れるフック。v1.15
以前は Application Strategy でした。
F. STAR stories — ロールに合わせた、貼り付け可能な S-T-A-R
ブロック 1–3 件。v1.15 以前は Verdict (生 score) でした。
score は現在 legitimacy と並んでレポートヘッダに表示されます。
レポートの保存
💾 Save report をクリック (または API 呼び出しの save トグル) で
markdown を reports/<date>-<company>-<role>.md に永続化します。
レポートのパース済みヘッダ (Score / Legitimacy / URL) は
Reports ページと Dashboard に表示されます。
10 件以上の JD があるならバッチ評価
単一 JD には #/evaluate ページが最適ツールですが、pipeline に
キューされた 10 件以上の URL に対しては JD ごとのクリックスルーは
非現実的です — 第 14 章の Batch evaluate サブセクション (親で
./batch/batch-runner.sh を実行) にジャンプして一晩回し、結果を
#/reports / #/tracker で確認してください。完全フローは
batch-evaluate-offers。
10. レポート (#/reports)
保存されたすべての評価をブラウズします。ページは カード ビュー
(rep2.viewCards)で開きます — レポートごとに 1 枚のカード:
表示タイトル、日付、legitimacy バッジ、そして色分けされたスコア
ピル(緑 ≥ 4.0、黄 ≥ 3.0、それ未満は赤。ヘッダに解析可能なスコアが
ない場合は落ち着いた「スコア未検出」ピル)です。行をざっと読みたい
ときは、密度の高い 表 ビュー(rep2.viewTable)に切り替えられ
ます。すべてのカードと表の行は、そのスコア帯に対する 提案される
次のステップ も示します:今すぐ応募 — 適合度高
(rep2.actApply)、応募、またはまず紹介先を探す
(rep2.actContact)、まず企業をリサーチ(rep2.actResearch)、
個人的な理由がなければ見送り(rep2.actLow)— どれも正しい
ページへの直接リンクです。スコアのないカードには、レポート自身を
指すツールチップ付きの落ち着いた スコア未検出 ピル
(rep.scoreUnparsed)が表示されます。
正しいレポートを見つける。 リストの上にフィルター行があり、 すべてが組み合わさります:
- レポートを検索 (
rep2.searchLabel) — 各レポートの会社・役職・ 表示タイトルに一致する自由テキスト。 - 会社 (
rep2.companyLabel) — ドロップダウンから 1 つの 雇用主を選びます。 - スコア帯 (
rep2.bandLabel) — 高 (4.5+) / 良 (4.0+) / 中 (3.5+) / 3.5 未満(rep2.bandHigh…rep2.bandLow)に 加えて、解析可能なスコアを持たないレポート用の区分。 - 開始日 / 終了日 (
rep2.dateFrom/rep2.dateTo) — リストを期間に絞ります。 - 並び替え (
rep2.sortLabel) — 日付 / スコア / 会社(rep2.sortDate…)、昇順または降順 (rep2.sortDirAsc/rep2.sortDirDesc)。 - スコア分布 — 列をクリックで絞り込み (
rep2.histogramLabel) のヒストグラム — 列をクリックするとその帯に絞り込め、パイプラインの 形を一目で把握できます。 - フィルターをリセット (
rep2.reset) ですべてをクリアします。 何も一致しないときは、白紙のグリッドの代わりにその旨が表示されます (rep2.noMatches)。
カード(または表の行)をクリックすると完全な markdown を読めます。 ページネーション:1 ページ 20 件、下部にコントロール。フィルターを 変更するたびに 1 ページ目へ戻ります。
単一レポートビューにはさらに:
- ← All reports — グリッドに戻る。
- 🔗 Open JD — 元の求人投稿を新規タブで開く。
レポートを PDF に書き出す
保存済みのレポートを開き、📄 PDF を生成 をクリックします。親プロジェクトで
generate-pdf.mjs を実行し、ファイルを output/*.pdf に書き込みます(Playwright
が必要で、ヘルス(Health)ページで導入状況を確認できます)。どこにも送信されません。
応募に添付する前に PDF を確認してください。
求人チェック — JD 完全性チェック (v1.262.0)
個別レポートのヘッダーアクションにある 🛡 求人チェック ボタンは、そのレポートのアーカイブ済み JD(スラグのレポート番号で解決される jds/ キャプチャ)に対して、親プロジェクトの決定論的 zero-LLM 完全性ゲートを実行します。結果はインラインで表示されます — 判定、各チェック、その理由。すべてローカルで実行: モデル呼び出しなし、書き込みなし。親のチェックアウトに posting-guard.mjs がまだ無い間は、失敗する代わりに「script not found」の注記が正直に返されます。
11. トラッカー (#/tracker)
CRM です。応募 1 件 = 1 行。data/applications.md に GitHub
Flavored Markdown テーブルとして保存されます。
各行のステータスバッジはセレクトにもなっています — ステージを選ぶと即座に保存されます: サーバーは正規の set-status.mjs をリレーし、行はその場で更新されます; 保存に失敗すると値が元に戻り、トーストが表示されます。手作業で編集された不明なステータスを持つ行と、N/A と番号付けされたバックフィル行は、代わりに読み取り専用のバッジを表示します。
ステータスフロー
Evaluated → Applied → Responded → Interview → Offer /
Hired / Rejected / Discarded / SKIP。
Hired(v1.118.0)は幸せな最終ステータス — オファーを受諾したことを意味します。トラッカーはお祝いバッジで表示し、内定獲得バナーで迎えます。
ステージタブボード(v1.131.0)。 テーブルの上部にあるステージタブ帯を使うと、ファネルをたどることができます:All タブに加え、正規ステータスごとのタブがそれぞれ全履歴のライブ件数を表示します — ゼロ件のステージも含むため、パイプライン全体を一目で常に見渡せます。あるステージをクリックするとテーブルがそのステージに絞り込まれ、もう一度クリックすると All に戻ります。タブ(と、ローカライズ済み/レガシーなステータスエイリアスを畳み込む件数)は GET /api/tracker/stages から供給され、これはサーバーが使うのと同じ templates/states.yml を読み込むため、ページ上にハードコードされたリストなしで、タブ構成は親のステータス語彙と自動的に同期し続けます。検索・スコアフィルタ・ソート可能な列・行ごとのレポート/PDF/正当性表示は変更なく、ロゴを有効にすると各行の企業にブランドマークが表示されます。
カンバンビュー (v2)。 同じボードはドラッグ&ドロップの
カンバン としても読めます:正規ステータスごとに 1 列
(ボードのタイトルは ステータス別の応募 と読み上げられます、
track.kanbanBoardAria)、応募ごとに 1 枚のカードです。カードを
別の列へドラッグする — またはフォーカスして 移動 を押す — と、
変更は 何かが書き込まれる前にプレビューされます
(track.kanbanMoveHint);確定した移動は結果ジャーナルに記録され
data/applications.md を書き換え、カードがそのことを伝えます
(track.moveJournal)— ステータスを戻すには、行の 結果
ボタンを使います。パイプラインが自分で管理する列(と、その意味を
あなただけが決められる Discarded)は読み取り専用として
レンダリングされ(track.kanbanReadOnly)、ドロップを拒否します。
親の結果レコーダーが見つからない場合、ステータスの移動は正直な注記と
ともに無効化されます(track.kanbanMovesOff)。ボードの読み込み中は
アプリの他の部分と同じシマー状の行を表示し、空のボードには
応募はありません(track.kanbanEmpty)とパイプラインへの
案内(track.emptyBody)が示されます。
ステータスのホワイトリストはサーバサイドで強制されます。
POST /api/tracker に他の値を送ると Evaluated にデフォルト
されます。正規の Evaluated → Applied 遷移は、/career-ops apply
の最後で Submitted. を確認した時点で自動的に発生します (第 14 章
参照)。
列レイアウト
| 列 | 内容 |
|---|---|
# |
自動採番、ゼロパディング (001、002、…)。 |
Date |
ISO 日付 (YYYY-MM-DD)。デフォルトは当日。 |
Company |
フリーテキスト。パイプ () と改行は自動エスケープされます。 |
Role |
同上。 |
Score |
N/5 形式 (例: 4.2/5)。 |
Status |
ホワイトリスト化された列挙型。 |
PDF |
該当行で generate-pdf.mjs が成功すると ✅。 |
Report |
対応する reports/*.md への markdown リンク。 |
Notes |
フリーテキスト、200 文字でキャップ。 |
フィルタ
- Status ドロップダウン。
- Score ドロップダウン —
≥ 4.0(高)、≥ 3.0(中)、< 3.0(低)。 - Search — company + role に対する部分一致。
すべてのフィルタは paginator を 1 ページ目にリセットします。 1 ページ 25 行。
メンテナンスボタン
- ▶ Normalize は
normalize-statuses.mjsを実行 — ステータスの 綴りを正規化 (applied→Applied、interview→Interview)。 - ▶ Dedup は
dedup-tracker.mjsを実行 —(company, role)を キーに大文字小文字非依存で重複行を削除。 - ▶ Merge は
merge-tracker.mjsを実行 —batch/tracker-additions/*.tsv(親の batch フローが Apply ヘルパー 経由で投入した応募を置く場所) からペンディングエントリを取り込み ます。重複排除し、処理済みファイルはbatch/tracker-additions/merged/にアーカイブします。上流の batch フローは batch-evaluate-offers を参照してください。
行の追加
POST /api/tracker — ボディ { company, role, score?, status?, url?, reportSlug?, notes?, date? }。(company, role) を
大文字小文字非依存で重複排除します。UI からは、Evaluate ページが
採点成功後に “Add to tracker” ボタンを提供します。
別トラッカーの CSV を取り込む (v1.262.0)
ツールバーの CSVを取り込む ボタンは、他のトラッカーの CSV エクスポート(Teal、Huntr、Simplify、手作りのスプレッドシート — company/role/status/date/url の列エイリアス、RFC-4180 パース)を受け取り、各行をその結果つきでプレビューします — 取り込み / 同じ求人 URL の重複 / スキップ。記録されるのは確認後のみです。アプリが認識しないステータスも行をブロックしません — Evaluated として注記付きで登録されます。日付は ISO、日先頭(day-first)、月名のいずれの形式も解釈します。
「まだ募集中?」 — ATS 求人がまだ開いているか確認
ATS(Greenhouse、Lever、Ashby、Workday、SmartRecruiters)にホストされた求人へのリンクを持つ追跡行ごとに、小さな まだ募集中? ボタンが付きます。押すと、アプリがその ATS 自身の公開 JSON エンドポイントに求人がまだ生きているかを尋ねます — ブラウザなし、AI トークンなし、保存なし。3 つのバッジのいずれかが出ます:
- 募集中 — 求人はまだ掲載されています。
- 終了 — ATS が確定的な「消滅」(HTTP 404/410)を返したので、この求人は取り下げられました。
- 不明 — チェックが決定的でなかった(URL が認識される ATS 求人でない、または API がレート制限・タイムアウト・曖昧な応答だった)。
このチェックは意図的に保守的です:はっきりした 404/410 のときだけ 終了 と言い、推測では決して言わないので、実際にはまだ開いている求人からあなたを遠ざけることはありません。Lever の公開 API は非権威として扱われる(一部の非公開求人を隠す)ため、その場合は終了ではなく 不明 になります。
結果を記録する
応募が終わりを迎えたら — 内定をもらった、入社した、見送られた、あるいは音沙汰がなかった — そのトラッカー行の 結果 ボタンを押して記録します。プレビューして確定する小さなモーダルが開きます:
- 何が起きたかを選ぶ — 不採用、オファー受領、採用 / 承諾、オファー辞退、返信なし / 音信不通、または面接に進んだ。
- メモ(任意) — 自分用の短い一行。
- プレビュー — アプリが何をするかを正確に表示し(例:「#12 Acme → 不採用 に設定します」)、まだ何も書き込みません。
- 結果を記録 — それを確定します。
記録は三つのことを同時に行います:結果を追記専用の結果ジャーナルに追加し、その応募で提出した CV とカバーレターを応募ごとの結果フォルダに保管し、行の正規 ステータス を同期します — こうして 採用 や 不採用 が、表を手で編集しなくてもトラッカーと統計に現れます。他のトラッカー機能と同様、結果を記録 を押すまでは読み取り専用で、アプリの隣に親 career-ops プロジェクトが必要です(そのプロジェクトが無い場合ボタンは非表示になります)。
12. 深掘りリサーチ (#/deep)
構造化された企業ブリーフを生成します: スナップショット、エンジニア リング文化、最近のニュース、Glassdoor センチメント、面接プロセス、 交渉のレバレッジポイント、リクルータに尋ねるべき賢い質問 3 つ。
入力
2 つのフィールド — 会社名と (任意) ロール。構造はモードテンプレート
(modes/deep.md) によって形作られます。
出力経路
Evaluate と同じフォールバックチェーン:
- Anthropic ライブ (推奨) —
bundleProjectContextが cv + profile +_shared.md+deep.mdをインライン化します。 出力: グラウンディングされた 10–30 KB の markdown をinterview-prep/<company>-<role>.mdに保存。 - Gemini ライブ —
gemini-eval.mjsの呼び出し。保存先は同じ。 - 手動プロンプト — ページが Claude Code (WebFetch + WebSearch を持ち実リサーチが可能) 向けの即使用可能なプロンプトを 返します。
コツ
claude-sonnet-4-6での Anthropic は通常、呼び出しあたり 1–3 分で 約 13 KB の有用なテキストを返します。- Anthropic SDK には組込みのウェブ検索がありません。最新ニュースや Glassdoor センチメントが必要なロールでは、手動プロンプトを Claude Code に貼り付け、その WebFetch ツールを使ってください。
- ライブ実行は課金されます。Sonnet 4.6 の深掘りリサーチ 1 回で 約 $0.30–0.50 です。
13. モードプロンプト (7 つの /#/<mode> ページ)
ケイデンスボード (v1.117.0)。 フォローアップページは、親の followup-cadence.mjs を用いた決定的なケイデンスボードで開くようになりました:応募ごとの緊急度(🔴 緊急 / 🟠 期限超過 / 🟡 待機 / 🔵 停滞)と次のステップまでの日数、さらに全ての Applied 行に最初のフォローアップ日を固定するフォローアップ日をシードボタン(followup-seed.mjs --backfill)。親スクリプトがなければ、ボードは正直に「利用不可」と表示します。
7 つのプロンプトビルダー: Project アイデア、Training
プラン、Follow-up メール、Batch 評価、リクルータへの
Outreach、Interview prep 1 ページ資料、Patterns
レトロスペクティブ。それぞれが特定の modes/<slug>.md テンプレートを
ラップします:
| ページ | Slug | 目的 |
|---|---|---|
#/project |
project |
ターゲットロール向けのポートフォリオプロジェクトを調整。 |
#/training |
training |
スキルギャップ分析 → カリキュラム。 |
#/followup |
followup |
面接後のメール下書き。 |
#/batch |
batch |
複数 JD のバッチ評価プロンプト。 |
#/contacto |
contacto |
リクルータ / リファラルへのアウトリーチメッセージ。 |
#/interview-prep |
interview-prep |
特定の面接ラウンド向けの 1 ページ準備資料。 |
#/patterns |
patterns |
「成功パターンは何か?」の内省分析。 |
共通の形
各ページは小さなフォーム (フィールドはモード固有)、▶ Generate prompt ボタン (手動)、そして — Anthropic または Gemini キーがあれば — プライマリに昇格する ⚡ ライブ実行 ボタンを持ちます。
▶ Generate prompt をクリックすると、フォーム値を JSON
シリアライズした User-supplied context: ブロックに、その後に
modes/<slug>.md テンプレートを逐語的に付けた組み立て済みプロンプトを
返します。コピーして好みの LLM に貼り付けます。
⚡ ライブ実行 をクリックすると同じプロンプトを Anthropic
(または Gemini) に送ります。bundleProjectContext 経由で cv.md +
profile.yml + _shared.md をインライン化します。結果はページに
描画され、コピー可能、.md としてダウンロード可能です。
7 つのページは明示的なホワイトリストです。専用ルートを持つモード
(oferta → Evaluate、deep → Deep research) と、親プロジェクトが
Claude Code 内でのみサポートするモード (apply、scan、
pipeline、tracker、pdf、latex、ofertas、auto-pipeline)
は意図的にこの UI から外されています。
14. 応募チェックリスト (#/apply)
応募を決めたら、この Apply ヘルパーページが実際の応募ステップ用の
送信チェックリストを生成します。フォームの自動入力は 行いません
— そのフローは親プロジェクトの Playwright を使う Claude Code 内の
/career-ops apply に残されています。
SPA チェックリストモード (#/apply)
SPA のチェックリストは、Playwright を起動せず手動でフォームを
埋めたいユーザ向けです。空のページでは推測に委ねられません:
応募チェックリストを生成 と実例つきの説明
(v2empty.apply.emptyTitle / v2empty.apply.emptyBody)を示し、
すでに求人を評価済みなら 評価済みレポートを選ぶ
(v2empty.apply.pickReport)への近道が出て、そのレポートのデータから
チェックリストを始められます。以下を含みます:
- Claude Code で
/career-ops apply <url>を実行し、Playwright で フォームを読み取り (手動入力なら本ステップはスキップ)。 - 投稿がまだ有効かを確認 (
check-liveness.mjs)。 - CV が最新かを確認 (
cv-sync-check.mjs、score ≥ 4.0 なら PDF)。 cv.mdの STAR+R 根拠点を使い、カバーレター / “Why us?” 回答を ロールに合わせる。- EEO / スポンサーシップ / 開始日の質問に正直に回答。
- 入力済み回答を
interview-prep/{company}-{role}.mdに送信前に 保存。 - 絶対に自動送信しない — 最終ボタンは人間 (あなた) がクリック。
- 送信後:
data/applications.mdに行を追加 (または TSV をbatch/tracker-additions/に書く)。
手動入力 vs Playwright 支援
実送信には 2 つのルート:
- 手動 — 通常のブラウザタブで採用ページを開き、上記の SPA チェックリストに従い、回答をコピペします。Playwright 不要です。 フォームが短いか、Chromium をインストールしていない場合に使用。
- Playwright 支援 — Claude Code (親プロジェクト) で
/career-ops apply <company>を実行。Playwright が独自のブラウザを 開き、すべてのフォームフィールドを読み、番号付きの下書き回答を 返します。Submit はあなたがクリックします。フォームが長い、 動的、またはどの質問にどう答えたかの監査証跡が欲しい場合に使用。
完全な CLI apply フロー (apply-for-a-job)
前提条件:
- まず
/career-ops pipelineを実行し、JD がreports/配下に 評価レポートを持っている状態にします。apply コマンドは既存の 評価に依存します。なければ最初に pipeline を実行してください。 - レポートとプロフィールがロード済み。
- 推奨: Playwright がインストール済み
(
npx playwright install chromium— 下記 Playwright Setup 参照)。なければ WebFetch (テキストのみのフォームプレビュー、 クリック入力なし) にフォールバックします。
番号付きフロー (正規 8 ステップ):
-
コマンドを実行、会社名を指定:
/career-ops apply <company>例:
/career-ops apply Anthropic。引数なしの場合、次のターンで フォームのスクリーンショット、フォームテキストの貼り付け、または 応募 URL を供給します。 -
レポートを特定。 システムは
reports/内の対応する評価 (/career-ops pipelineまたは以前の#/evaluateで作成された もの) を見つけます。 -
フォームを開く。 Playwright がブラウザウィンドウを 自動的に起動 — 自分で開く必要はありません。
-
フィールドを読む。 システムはすべてのフォームフィールド (ラベル、型、required、select の選択肢) を読み取りパースします。
-
回答を生成。 career-ops はプロフィール、根拠点、ロールに 基づいて各フィールド向けにカスタマイズされた回答を作成します。
-
番号付きリストを返す。 フォームレイアウトに合わせて並べられた 回答が返ります — シンプルなフィールド (名前、メール) が先、 フリーテキストフィールド (カバーレター、“Why us?”) は後。 フラグ付きの項目は人間の判断が必要なもの — 給与アンカー、 レジュメの不足詳細、任意質問 — を指し示します。
-
手動入力。 あなたが各回答を対応するフィールドにコピペします。 このステップは手動、自動化されません。各回答を必ず先にレビュー してください。
-
ユーザが送信。 Submit はあなた自身がクリック。career-ops は 絶対に Submit をクリックしません。チャットで以下を入力して 完了を確認:
Submitted.
Submitted. 時の自動更新:
data/applications.mdでステータスがEvaluated → Appliedに 反転。- 入力済み回答は将来の参照のためレポートのセクション G に 永続化されます。
Tracker への引き渡し:
/career-ops trackerロールの score に関係なく、pipeline 全体のステータスを監視します。
バッチ評価 (batch-evaluate-offers)
一度に 10 件以上の JD を採点する場合 (SPA の 1 件ずつの
#/evaluate はそのボリュームには非現実的)、CLI のバッチランナーを
使います。#/batch ページも同じ正直さで迎えます:空の状態には
求人リストから始めましょう(v2empty.batch.emptyTitle)と
URLリストを貼り付け(v2empty.batch.pasteList)ヘルパーが
あり、クリップボード上の裸の http(s) URL を入力欄へ直接持ち上げます
(v2empty.batch.pasteAdded)。CLI ランナーに降りる前に、
batch-input.tsv 相当の行が数秒で組み上がります。
入力ファイル — batch/batch-input.tsv (タブ区切り):
| 列 | 目的 |
|---|---|
id |
一意の連番 |
url |
求人投稿の完全リンク |
source |
出所プラットフォーム (LinkedIn、Greenhouse など) |
notes |
任意のコンテキスト詳細 |
行の例:
1<TAB>https://jobs.example.com/senior<TAB>LinkedIn<TAB>./batch/batch-runner.sh のフラグ:
--dry-run— 評価せずペンディングのオファーをプレビュー。常に 最初にこれを実行して TSV を検証してください。--parallel N— N 個のワーカーを同時実行 (推奨は 1、2、または 3)。--min-score X.X— 閾値未満のオファーは永続化をスキップ。高 フィットロールのレポートのみ保持したい場合に便利。--retry-failed— 前回ランでエラーになったオファーのみ再処理 (ネットワーク失敗、レート制限)。--max-retries N— 失敗したオファーを N 回まで再試行 (デフォルト: 2)。--model NAME—claude -p --modelに渡す Claude モデル (career-ops 1.8.0, #504)。未設定 = Claude Max サブスクリプションの既定モデル。大規模バッチには安価なモデルを、例:claude-sonnet-4-6。#/batchでは モデル 入力として表示 (web-ui 1.31.0)。--start-from N— N 未満のオファー ID をスキップ (部分処理済みバッチを再開)。#/batchでは 開始 # 入力として表示 (web-ui 1.31.0)。
標準シーケンス:
-
batch/batch-input.tsvを 編集 — JD ごとに 1 行。 -
ドライラン (まず推奨):
./batch/batch-runner.sh --dry-run -
実行 — 逐次または並列:
./batch/batch-runner.sh # 1 件ずつ ./batch/batch-runner.sh --parallel 2 # 同時 2 件 ./batch/batch-runner.sh --parallel 3 # 同時 3 件 ./batch/batch-runner.sh --parallel 2 --min-score 4.0 # 高フィットのみ永続化 -
失敗の再試行 (ネットワーク / レート制限):
./batch/batch-runner.sh --retry-failed --max-retries 3 -
レポート は
reports/配下に{id}-{company}-{YYYY-MM-DD}.mdとして作成されます。サマリ行はbatch/tracker-additions/に追記されます。 -
Tracker にマージ:
node merge-tracker.mjs                 # バッチ追加を適用
node merge-tracker.mjs --dry-run       # マージのプレビュー
マージコマンドはエントリを重複排除し、処理済みファイルを
batch/tracker-additions/merged/にアーカイブします。
SPA は結果のレポートを #/reports (ページネーション、score
ピル色付け) に、tracker 行を #/tracker に — #/evaluate から
1 件ずつ追加したのと全く同じように — 表面化します。CLI に降りたく
ない場合は #/tracker の ▶ Merge メンテナンスボタンと
ペアで使ってください。
Playwright セットアップ (set-up-playwright)
career-ops の以下 2 つの機能に必須です:
- フォーム入力 (
/career-ops applyの上記ステップ 3 — Playwright がブラウザを開き、フィールドラベルを読み、回答を提案)。 - PDF 生成 (
/career-ops pdfと SPA の 📄 PDF を生成 ボタン:#/cv/#/reports/:slug/#/evaluate/#/deep/#/interview-prep)。
Playwright がない場合のフォールバック: apply フローは WebFetch (テキストのみのフォームプレビュー、クリック入力なし) に フォールバックします。PDF 生成は単にエラーになります。
コアセットアップ (career-ops 親ルートで実行):
# Playwright 用の Chromium をインストール
npm install
npx playwright install chromium

# Playwright MCP を登録し Claude Code がフォームを駆動できるように
claude mcp add playwright npx @playwright/mcp@latest

# 3 つのコンポーネント (Chromium、Playwright lib、MCP) を検証
npm run doctor
代替の MCP 登録方法 — .claude/settings.local.json に追加:
{
  "mcpServers": {
    "playwright": {
      "command": "npx",
      "args": ["-y", "@playwright/mcp@latest"]
    }
  }
}
動作の注意点:
- デフォルトはヘッドレス。 Playwright は静かに動作します。
ブラウザの動作を見たい場合は Claude に
open up with playwright the browser and fill out the entire form.と伝えてください。 - 1 つのパッケージで 3 役 — Playwright の npm インストールで、
ブラウザ自動化ライブラリ、
/career-ops pdfの PDF レンダリング エンジン、(MCP 経由で) Claude Code 内のフォーム入力ワークフローが 揃います。 - 依存する前に検証 —
npm run doctorで 3 つすべてが動作中で あることを確認できます。SPA の Health ページは欠けていれば即時 失敗するPlaywright (parent node_modules)チェックを表示します。
15. 面接準備
これはリサーチ後、面接前のフェーズです。本アプリの 3 つの成果物が 収束します:
- 保存済み深掘りリサーチファイル (
interview-prep/配下)、 実行した company-role ペアごとに 1 つ。Deep research ページ または/api/interview-prepエンドポイント経由でブラウズします。 - Patterns モード (
#/patterns) — 自己内省プロンプトを生成: 「直近 N 回の面接 / オファー / 不合格を通じて、どんなパターンが 保たれているか?」 tracker 行が 5 件以上溜まったときに有用。 - Interview-prep モード (
#/interview-prep) — 特定の今後の ラウンド (行動、技術、システム設計) 向けに 1 ページ資料を事前 入力。出力は同じinterview-prep/フォルダへ。
推奨ワークフロー
予定されている各面接について:
- Deep を再実行 (または保存済みファイルを開く) を前日に。
#/interview-prep— 特定ラウンド向けに 1 ページ資料を 生成。自分のノートに貼り付けます。- システム設計 / コーディングラウンド —
#/trainingを開き、 JD が強調する特定サブシステムについて 30 分の的を絞った リフレッシュを依頼。 - 報酬ラウンド — 深掘りリサーチファイルを開き「Negotiation leverage points」へ。具体的なデータポイントを 2–3 件 (Glassdoor のバンド、最近の資金調達、他社の同等オファー) 持参。
- 行動ラウンド — 元の Evaluate レポートのセクション B に
入った STAR+R ストーリーを
cv.mdから引いてくる。
面接後、すぐに:
- tracker 行を更新: ステータス →
Responded(続いてInterview、Offerなど)。 #/followupを実行してお礼メールを下書き。- 新しい情報 (報酬レンジ、チーム構成、技術スタックの意外な点) が
あれば、保存済み
interview-prep/<company>-<role>.mdを## Post-round notesで編集し、未来の自分が参照できるように します。
16. アクティビティログとトラブルシューティング
アクティビティログ (#/activity)
サーバに到達した、状態を変更するすべてのリクエストの監査証跡です。 記録対象: pipeline 追加、tracker 書込み、CV 保存、JD 保存、 evaluate 実行、deep-research 実行、scan 実行、設定変更、モード 実行。
シークレット (ANTHROPIC_API_KEY、GEMINI_API_KEY) は受信時に
編集 (redact) されます。data/activity.jsonl で実キー値を目に
することはありません。
アクションプレフィックス (pipeline.、cv.、evaluate、
scan. など) でフィルタ可能。1 ページ 25 行、サーバは直近最大
500 イベントを返します。
トラブルシューティング
| 症状 | 想定される原因 | 修正 |
|---|---|---|
Health ページが cv.md で赤 |
初回起動、ファイルがまだ存在しない | touch $CAREER_OPS_ROOT/cv.md してリロード。 |
Health が Profile customized で赤 |
candidate.full_name がまだ Jane Smith |
config/profile.yml を編集。 |
スキャンログの hh.ru: HTTP 451 または 403 |
送信元 IP がロシア国外、または hh.ru が VPN/データセンターと判定 | ロシアの家庭用 IP から実行してください。キーや User-Agent の設定は存在せず、スキャナーが自らブラウザー UA を送ります。 |
gemini-eval.mjs: ERR_MODULE_NOT_FOUND |
親プロジェクトの依存が未インストール | cd $CAREER_OPS_ROOT && npm install。 |
| Generate PDF がエラー | 親に Playwright が未インストール | cd $CAREER_OPS_ROOT && npx playwright install chromium。 |
/career-ops apply が “no report found” |
この JD で pipeline がまだ採点していない | まず /career-ops pipeline (または #/evaluate) を実行; 第 14 章の前提条件を参照。 |
batch-runner.sh: no such file |
間違ったディレクトリで実行 | cd $CAREER_OPS_ROOT してから ./batch/batch-runner.sh を起動。 |
サーバが EADDRINUSE: 4317 を報告 |
古いインスタンスがまだ実行中 | pkill -f 'node server/index.mjs' してから再起動。 |
| ライブ LLM 呼び出しが 2 分超ハング | プロンプトが巨大、または Anthropic が低速 | /api/health の Anthropic フラグを確認; サーバはプロンプトを 256 KB でソフトキャップし 413 を返します。 |
Pipeline プレビューに (unsafe redirect) |
投稿がプライベート IP / ループバックへリダイレクト | これはセキュリティ機能です (REVIEW-B1)。リダイレクト先は拒否され、元の URL は変更されません。 |
| Tracker 行のテキストがテーブルを壊す | v1.9.1 以前で会社名にパイプ | v1.9.1 以上へ更新 — パイプはエンドツーエンドでエスケープされます (BF-1)。 |
新規クローンで npm test が失敗 |
テストが親プロジェクトレイアウトを仮定 | CAREER_OPS_ROOT=$(mktemp -d) を使ってフィクスチャをブートストラップ。 |
より詳細な診断には: Health ページで doctor を実行 を実行し、出力を コピーし、issue トラッカー https://github.com/Fighter90/career-ops-ui/issues を検索して ください。
17. 新しい求人ポータルソースを追加する方法
career-ops-ui は各求人サイトを アダプタ として扱います — server/lib/sources/<slug>.mjs 配下の 1 ファイルが、1 サイトの結果取得と正規化の方法を持ちます。server/lib/sources/ レジストリは 129 個のソースを同梱しています — 英語圏 124 個 + ロシア系 5 個 のボードです。英語圏のセットは主要な ATS(Greenhouse / Ashby / Lever / Workable / SmartRecruiters / Workday)、明示的な provider: で選択されるボード全体のアグリゲーター(RemoteOK, Remotive, We Work Remotely, NoDesk, Get on Board, Amazon, …)、および careers_url ホストまたは明示的な api: URL から自動検出されるテナント単位の ATS(BambooHR, Personio, Recruitee, Teamtailor, Avature, SAP SuccessFactors, …)にわたります。Deel ジョブプラットフォーム上のボード(jobs.deel.com/<slug> — Klarna などが公開するマルチテナントボード)は URL から自動検出されます。追加は portals.yml への 2 行です。完全なリストをここで手作業で数える必要はまったくありません — server/lib/sources/ から自動検出され、#/scan の Source ドロップダウンにライブで表示されます。 YAML は §5、コピー&ペースト用のエントリは docs/portals-examples.md を参照してください。
v1.69.0 (P-14) — ドロップイン自動検出。 12 個目のソース追加はいまや ファイルを置くだけ で完結します。レジストリ (
server/lib/sources/registry.mjs) は手書きリストを持たなくなりました — 起動時にこのフォルダを スキャン (readdirSync+ 動的import()) し、全*.mjsからexport const metaブロックを収集します。アダプタを書いてmetaを宣言すれば、スキャナ・#/scanフィルタドロップダウン・RU ディスパッチャに即座に認識されます —registry.mjsの編集は不要。(RU ソースは引き続き親のportals.ymlに 1 行必要です。ステップ 5 参照。)
ステップ 1 — アダプタを書く
server/lib/sources/<slug>.mjs を作成します。ソースに JSON API があるかどうかによって 2 つのパターンが使えます:
API バックエンド付きソース(最もクリーン — サイトにオープンデータエンドポイントがあれば優先):
// server/lib/sources/example.mjs
const ENDPOINT = 'https://example.com/api/v1/vacancies';
const UA = 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) ...';

// v1.69.0 (P-14) — self-describing metadata. The registry auto-discovers
// this block at boot; THIS is what registers the source (see Step 2).
export const meta = {
  value: 'example',          // ← must equal job.source written below
  label: 'Example.com',      // ← shown in the #/scan filter dropdown
  region: 'ru',              // ← 'en' (ATS sweep) | 'ru' (regional dispatcher)
  configKey: 'example',      // ← RU only; the key used in portals.yml
};

export async function searchExample(query, opts = {}) {
  const { onlyRemote = false, fetchImpl = fetch, signal } = opts;
  const res = await fetchImpl(`${ENDPOINT}?text=${encodeURIComponent(query)}`, {
    signal,
    headers: { 'User-Agent': UA, Accept: 'application/json' },
  });
  if (!res.ok) {
    const err = new Error(`Example: HTTP ${res.status}`);
    err.status = res.status;
    throw err;
  }
  const data = await res.json();
  return (data.items || []).map(normalizeExample);
}

function normalizeExample(item) {
  return {
    id: `example-${item.id}`,
    title: item.title || '',
    company: item.company?.name || '',
    url: item.url || '',
    salary: item.salary || '',
    location: item.location || '',
    isRemote: !!item.remote,
    workplaceType: item.remote ? 'Remote' : 'Onsite',
    relocates: false,
    date: item.posted_at || '',
    snippet: (item.description || '').slice(0, 240),
    source: 'example',           // ← must match the registry `value` exactly
  };
}
HTML スクレイプソース(API がない場合 —
getmatch.mjs と
geekjob.mjs に完全な例があります):
const BASE = 'https://example.com';

export async function searchExample(query, opts = {}) {
  const { fetchImpl = fetch, signal } = opts;
  const res = await fetchImpl(`${BASE}/vacancies?q=${encodeURIComponent(query)}`, {
    signal,
    headers: { 'User-Agent': UA, Accept: 'text/html' },
  });
  if (!res.ok) {
    throw Object.assign(new Error(`Example: HTTP ${res.status}`), { status: res.status });
  }
  return parseExampleCards(await res.text());
}

export function parseExampleCards(html) {
  // …regex-based card extraction. Return [] on parse failure (DON'T throw):
  // a healthy 200 with no parseable cards is "no results", not "error",
  // so the multi-source scanner can keep going.
}
アダプタが必ず守るべき 3 つの契約:
- 有効な
metaブロックをエクスポートする(ステップ 2 参照)。ない場合、レジストリはそのファイルを起動時に静かにスキップします(起動時にconsole.warn1 回)。ソースは一切表示されません。 optsに{ onlyRemote, fetchImpl, signal }を受け取る。fetchImplはアダプタをネットワークなしでテスト可能にし、signalはクライアント切断の伝播に必要です (REVIEW-B3)。- 共通の形のレコードを返す —
{ id, title, company, url, salary, location, isRemote, workplaceType, relocates, date, snippet, source }で、sourceはmeta.valueと一致すること。
ステップ 2 — アダプタの meta を宣言する(自動登録)
これが登録ステップのすべてです。registry.mjs は編集しません。
アダプタが meta ブロックをエクスポートしていれば、レジストリが起動時に自動検出します:
// at the top of server/lib/sources/example.mjs
export const meta = {
  value: 'example',          // job.source value AND #/scan option.value
  label: 'Example.com',      // display label in the dropdown
  region: 'ru',              // 'en' | 'ru'
  configKey: 'example',      // RU only — key in portals.yml::russian_portals.sources
};検出時のバリデーションルール(いずれかに違反したファイルはスキップされ、[sources/registry] 警告が 1 件出力されます — 移行途中のブランチでも原因が追えます):
value— 空でない文字列。アダプタが書くjob.sourceと一致すること。label— 空でない文字列。region— 正確に'en'または'ru'。それ以外は拒否。configKey—region: 'ru'では 必須、'en'では無視。
region: 'en' は ATS スイープに加わります(tracked_companies の URL パターンから自動検出)。region: 'ru' はリージョナルディスパッチャに加わります。公開 API
(SOURCES、SOURCES_BY_REGION、RU_CONFIG_KEYS、getRegionalSources) は検出された全 meta から再構築され、en 優先・各リージョン内でラベルのアルファベット順に並ぶので、ドロップダウンの順序はユーザに対して安定します。
ステップ 3 — ディスパッチャに配線(RU のみ)
EN ATS ソースは tracked_companies の URL パターンから自動検出されるため、追加の配線は不要です。RU ソースの場合は
server/lib/ru-scanner.mjs を開き、
RU_DISPATCH テーブルに 1 行追加します:
import { searchExample } from './sources/example.mjs';
// …
const RU_DISPATCH = {
  // …existing…
  example: { label: 'example.com', search: searchExample },
};
ディスパッチャループは cfg.sources に存在する各キーについて entry.search(query, opts) を呼び出します。それ以上のコード変更は不要です。
ステップ 4 — テスト(モック、ライブネットワーク禁止)
テストは tests/sources-<slug>.test.mjs に置きます。実ネットワークは
禁止 です (CI-isolation 契約):
import test from 'node:test';
import assert from 'node:assert/strict';
import { searchExample } from '../server/lib/sources/example.mjs';

test('searchExample normalizes one record', async () => {
  const fetchImpl = async () =>
    new Response(
      JSON.stringify({ items: [{ id: 1, title: 'Backend Engineer' }] }),
      { status: 200, headers: { 'content-type': 'application/json' } }
    );
  const out = await searchExample('q', { fetchImpl });
  assert.equal(out.length, 1);
  assert.equal(out[0].source, 'example');
});
ステップ 5 — 自分の portals.yml で有効化
親プロジェクトの portals.yml はユーザ所有の設定です。新しいソースの configKey を配列に追加します:
russian_portals:
  sources: ["hh", "habr", "trudvsem", "getmatch", "geekjob", "example"]
  area: 113
  per_page: 50
  only_remote: false
  queries:
    - "Senior PHP"
    - "Senior Go"
ブラウザで #/scan をリロードしてください。ソースフィルタのドロップダウンは新エントリを自動取得します(単一情報源:
GET /api/scan/sources →
registry.mjs)。
🌐 スキャンボタンは以降、全リージョナルスイープに新ソースを含めます。
参照アダプタ(新ソースはこれらをミラーする)
| アダプタファイル | 種別 | 備考 |
|---|---|---|
hh.mjs |
JSON API | 標準 RU API アダプタ。ジオ対応 UA フォールバック。 |
trudvsem.mjs |
JSON API | ロシア政府オープンデータ。IP ゲートなし。 |
habr.mjs |
HTML スクレイプ | ロシアの技術系掲示板。正規表現ベースのカードパーサ。 |
getmatch.mjs |
HTML スクレイプ | 防御的パーサ。パース失敗時は []。 |
geekjob.mjs |
HTML スクレイプ | GetMatch と同じ防御的スタイル。 |
greenhouse.mjs |
JSON API | 標準 EN ATS アダプタ。tracked_companies URL パターンを使用。 |
よくある落とし穴
metaエクスポートの忘れ。 v1.69.0 以降、metaブロックがソースを登録する 唯一 の手段です。metaがない(または不正な)場合、ファイルは起動時に静かにスキップされ、[sources/registry] <file> has no valid \export const meta` — skipped` という警告が 1 件だけ出ます。新しいアダプタがドロップダウンに現れない場合はサーバーログを確認してください。sourceフィールドの不一致。 アダプタが書き込む文字列はmeta.valueと完全に一致しなければなりません。ずれると、#/scanのフィルタドロップダウンにはソースが表示されますが、選択すると すべての行が除外されます(等価チェックがr.source === fsのため)。- パース失敗時に例外を投げる。 HTML スクレイパは、カードをパースできない
健全な 200 では
[]を返さなければなりません。例外を投げるとマルチソース ディスパッチャのループが壊れ — 一つの不正な HTML 構造が、同じクエリの 他のすべてのソースを巻き添えにします。 fetchImpl/signalの忘れ。 これらがないと、アダプタは 実ネットワークに触れずにユニットテストできず、クライアントの 切断も伝播しません(ユーザがタブを閉じてもバックグラウンドの フェッチが生き続けます)。- RU で
tracked_companiesを当てにする。 このリストは EN ATS ソース専用です。RU アダプタは代わりにrussian_portals.queriesから自走します — 企業ごとのエントリはありません。
18. 通知 (トップバーの 🔔)
v1.58.34 — 右下に表示される全ての toast を in-memory ジャーナル(上限 50、古いものは削除)に記録します。トップバーの 🔔 をクリックして右側の 通知 ドロワーを開き、見逃したメッセージを再確認できます。ジャーナルはタブ単位・セッション単位 — タブを閉じるとクリアされます。
ドロワーは ベルをクリックしたときだけ開きます(またはキーボード Enter / Space)。自動では開きません。赤いバッジは未読件数を表示し、開くとリセットされます。
カテゴリ
| カテゴリ | 発火条件 | 視覚的合図 |
|---|---|---|
| 成功 | 保存しました, コピー, 更新しました, スキャン完了, CV インポート, apply-checklist 操作, プロフィール保存 |
左ボーダー緑; 緑の toast 背景 |
| エラー | URL バリデーション失敗、API エラー ((METHOD /path · HTTP NNN) 付き)、ネットワーク失敗、pipeline-400 重複、doctor / verify 異常終了 |
左ボーダー赤; 赤の toast 背景; 技術詳細は 詳細 <details> に格納 (U-4) |
| 情報 / 進行 | Running doctor.mjs…, Running verify-pipeline.mjs…, Refreshing…, Loading…, スキャン進行 |
左ボーダーグレー |
エントリ表示項目: 時刻 (HH:MM:SS 言語別)、メッセージ (U-4 で末尾の技術情報を分離後)、必要に応じて (METHOD /path · HTTP NNN) 等の技術詳細 (monospace)。
通知ではないもの
- Doctor / verify の結果モーダル — モーダルであって toast ではない、ジャーナル外。
#/scan/#/autoの SSE ログ行 — ページ本体に直接書かれ、toast パイプラインを経由しない。- toast を伴わない spinner のみのローディング状態。
キーボード
- ベルを クリック または focus + Enter / Space → ドロワー開く。
- Esc、× ボタン、ベル再クリック → 閉じる; ベルにフォーカス戻る。
19. アプリを自分の言語にローカライズする
インターフェースは 19 言語で提供されます(English, Español, Français, Português, 한국어, 日本語, Русский, 简体中文, 繁體中文, Polski, Українська, Dansk, العربية, Deutsch, Italiano, Türkçe, हिन्दी, தமிழ், Tiếng Việt)。画面上のラベルはすべて翻訳辞書から来ており、アプリのロジックに触れずに言語を追加・修正できます。
翻訳の場所。 v1.60.0 以降、各言語は public/js/lib/locales/ 配下の個別ファイルです — i18n-dict.en.js、i18n-dict.es.js、i18n-dict.ru.js など — 'キー': 'テキスト' の単純な一覧です。共通の i18n-dict.aliases.js により、常に同じ表記であるべきキー(サイドバーのラベルとそのページタイトル)を 1 つの翻訳に向けられます。i18n-dict.js が読み込み時にまとめます。これは編集しません。
文言の修正・追加。 対象言語のファイルを開き、キー(例: 'nav.scan')を見つけてテキストを編集します。新しいラベルを追加するには、19 つすべての言語ファイルに同じキーと翻訳値を追加し、ページ内で t('your.key') として使います。npm test を実行してください — いずれかの言語でキーが欠けると失敗するため、中途半端な翻訳のまま出荷されません。
新しい言語を追加する。 i18n-dict.en.js を i18n-dict.<code>.js にコピーしてすべての値を翻訳し、コードを i18n.js(言語リスト + ブラウザ自動判定)と i18n-dict.js のアセンブラに登録し、index.html に <script> 行を追加します。テストのスナップショットやヘルプ / README の付随ファイルを含む完全なチェックリストは docs/LOCALIZATION.md にあります。
補足。 言語切替はサイドバー下部にあり、選択はブラウザごとに記憶されます。サーバーの診断メッセージは意図的に英語のままです(ログの一貫性のため) — 翻訳されるのは画面のインターフェースだけです。
ステップごとの完全なローカライズガイドはリポジトリの docs/LOCALIZATION.md を参照してください。
20. ターゲット職種別の統計 (#/stats)
Analytics → ターゲット職種の統計 ページは、スキャンがすでに収集しているまばらなデータを、あなたが実際に狙っている職種の市場像へと変換します。国ごとの求人数と給与水準、そして時系列で追える推移を示します。何も捏造しません。スキャナーが見つけたものだけを集計し、サンプルがどれほど薄いかについても正直です。
数字の出どころ
- ターゲット職種はプロフィール(
config/profile.yml→ target roles)から読み込まれ、ハードコードされていません。まず#/profileで設定してください。職種が未設定の場合、このページは空のグラフの代わりに「ターゲット職種を設定してください」という案内を表示します。 - 求人は最新のスキャンから取得されます(まず
#/scanで一度実行してください)。各求人の勤務地は国にマッピングされ(スキャンの国フィルターと同じ検出器)、給与文字列は解析されて概算の為替レート表を通じて USD に正規化されます。 - すべての集計はブラウザ内で行われます。データが端末外に出ることはなく、このページが書き込むのは、あなたが明示的に保存するスナップショットだけです。
グラフの読み方
- 国別の求人数: 一致した求人が各国にいくつあるか。上部の職種および国フィルターで、1つのターゲット職種や1つの国に絞り込めます。
- 国別の中央値給与(USD): 国ごとに解析された給与の中央値。解析可能な給与を持つ求人のみが集計され、サンプルサイズはグラフの横に表示されます。金額は概算レートで換算されるため、正確な値ではなく目安として読んでください。単独の
¥(日本円と中国元の間で曖昧)は、大きな FX の歪みを避けるため、推測せずに除外されます。 - 現在のスキャンに解析可能な給与がない場合、給与グラフは数字を捏造する代わりにその旨を表示します。
スナップショットの保存と推移の追跡
- スナップショットを保存をクリックすると、現在の集計が
data/role-stats.jsonlに追記されます。各スナップショットにはサーバー側でタイムスタンプが付きます。スナップショットはこのページが書き込む唯一のものであり、あなたの CV やプロフィールに触れることは決してありません。 - 推移グラフは、保存したスナップショット全体にわたる求人数をプロットします。定期的に(例えば毎週のスキャンのたびに)保存しておくと、ターゲット職種の市場が時間とともにどう動くかを観察できます。
21. あなたのツーページャー — 候補者としての市場適合度 (#/two-pager)
career-ops-ui の大半は「この求人は自分の CV に合っているか?」を問います。**ツーページャー(two-pager)は残り半分、すなわち「この求人は自分が本当に望むものに合っているか?」に答えます。これは Never Search Alone に登場する「Mnookin のツーページャー」**をモデルにしたもので、何が自分を活気づけるか、何を必須とするか、何を受け入れないかを一人称で簡潔に述べた文書です。Setup → Two-pager 🎯 から開きます。
AI自動入力 + エクスポート(v1.100)。 「✨ AI入力アシスタント」が履歴書から全フィールドをライブで入力するように(確認して保存);👁 プレビューとエクスポートはツーページャーを描画し、Markdown/PDF/DOCXにエクスポートします。
何を記入するか
- 私は何者か — あなたの実績と、あなたが力を発揮する役割の形について、一人称で数文。
- 理想の環境 — 望む企業の規模、ステージ、文化。
- 五つのチップリスト — 入力して Enter(またはカンマ)を押して各項目を追加し、× をクリックして削除します:
- 好きなこと — 活力を与える要素(リモート、オーナーシップ、ゼロからの開発、メンタリング…)。
- 必須条件 — 譲れない要求(報酬の下限、国、技術スタック…)。
- 嫌いなこと — 消耗させる要素(オンコール、終わりのない会議、レガシーのみ…)。
- 絶対に避けたいこと(Deal-breakers) — 完全に無理なもの(オンサイトのみ、ビザ支援なし、ある金額未満…)。
- 譲れない一線(Non-negotiables) — 境界線(勤務地、リモート、報酬の下限…)。
Save two-pager をクリックして保存します。これは親 career-ops プロジェクトのユーザーレイヤーの config/two-pager.yml に書き込まれるため — CV やプロフィールと同様に — システムを更新しても決して上書きされません。
AI 記入アシスタント
どう表現すればよいか分からない? ✨ AI fill assistant をクリックしてください。すぐに実行できるプロンプト(あなたの CV とプロフィールをインラインで含めた Mnookin 形式)を組み立て、ダイアログに表示します。そのプロンプトを任意の LLM で実行し、得られた YAML フィールドをフォームに貼り戻してください。このアシスタントが使うのはあなた自身の CV とプロフィールだけです — あなたに関する事実を捏造することはなく、このボタンからライブの API 呼び出しは行われません。
望むものとの適合スコア
ツーページャーを保存すると、#/scan のすべての求人に小さな ◎ N バッジ(0–100)が付きます。各求人の勤務形態(リモート/ハイブリッド/オンサイト)、国、報酬の下限、**移住(relocation)**を、あなたのツーページャーと照合します — 緑のバッジは高い適合を、赤は絶対に避けたい条件が発動したことを意味します。ホバーすると詳細が見られます(✓ 何が一致したか、✗ どの絶対条件に反したか)。
これは意図的に正直です: 求人が照合可能なシグナルをまったく与えないとき(たとえばあなたの希望がすべて、スキャン行では確認できない自由記述である場合)には、バッジはまったく表示されません — システムは決して数字を捏造しません。同じ対象について、緩やかな**嫌い(hate)よりも、強い絶対条件(deal-breaker)**の違反のほうが重く扱われます。バッジのほかにも、保存されたツーページャーはすべての LLM **評価(evaluation)**にインラインで含まれるため、あなたが述べた希望は CV 対 JD のマッチだけでなく、書面での判定にも反映されます。
22. 模擬面接 (#/mock-interview)
面接対策を読むことと、答えを声に出して言うことは別物です。模擬面接ページ(サイドバーの Interview prep → Mock interview 🎤 から開きます)は、特定の職務を相手にターンごとのリハーサルを進め、あなた自身の CV、プロフィール、ツーページャー、ストーリーバンクに基づきます。あらかじめ用意された質問リストではありません — 面接官は、あなたが実際に話した内容に反応します。
セッションを始める
- 対象の職務(および任意で企業)を入力します。手元にあれば求人票も貼り付けてください — 質問が目に見えて鋭くなります。
- Start interview をクリックします。面接官は、その職務とあなたの経歴に合わせた、的を絞った質問一つで口火を切ります。
- 答えを入力し Send answer をクリックします。好きなだけ繰り返してください — 固定のクイズではなく、会話です。
各ターンで得られるもの
答えるたびに、面接官は三つの部分で応答します:
- フィードバック — 何がうまく伝わったか(強み)と、何が欠けていたかを、STAR+R(Situation, Task, Action, Result, Reflection)の観点で示します。あなたが飛ばした具体的な次元を名指しします。
- スコア — 一行の根拠を添えた手早い
N/5で、セッションを通じた進歩を実感できます。 - 次の質問 — 直前の答えの最も弱い部分を意図的に突く追撃質問。
すべてはあなたの実際の資料に基づきます: cv.md、config/profile.yml、config/two-pager.yml、そしてあなたの STAR+R ストーリーバンク(interview-prep/story-bank.md)が、いずれもプロンプトにインラインで含まれます。面接官は本物の穴は突きますが、あなたにない経験を決して捏造しません。LLM キーが設定されていない場合、このページは任意のアシスタントに貼り付けてそのまま実行できるプロンプトを渡してくれます — アプリの他の箇所でも使われている、同じ正直なフォールバックです。
セッションの保存と再訪
リハーサルを終えたら Save transcript をクリックして残します。これは親プロジェクトのユーザーレイヤーの interview-prep/mock-{company}-{role}-{date}.md に書き込まれるため、他の面接対策ノートと並んで保存され、システム更新で上書きされることはありません。ページ下部の Saved sessions リストから、どの記録も再度開いたり削除したりできます。別の職務で最初からやり直すには New interview を使ってください。
23. ネットワーキングと企業の深掘りリサーチ (#/networking)
正面から応募するのはゲームの半分にすぎません。もう半分は誰かを知っていること、あるいは少なくとも誰に連絡し何を言うべきかを知っていることです。ネットワーキングページ(サイドバーの 深掘りリサーチ → ネットワーキング 🤝 から開きます)は、企業を、あなた自身の CV・プロフィール・two-pager に基づいて面接を勝ち取るための具体的な計画へと変えてくれます。
計画を立てる
- 企業(必須)を入力し、任意で職種と求人票を入力します。求人票は「なぜ自分が合うのか」のフックを鋭くします。
- 計画を立てるをクリックします。LLM キーがあればライブで実行され、計画をその場でレンダリングします。キーがなければ、任意のアシスタントに貼り付けられる用意されたプロンプトを渡します(アプリ全体で使われている同じ誠実なフォールバック — 何も捏造しません)。
計画に含まれる内容
計画は 4 つのセクションで返ってきます:
- 企業ドシエ — 企業が何をしているかの引き締まったブリーフ、引用する価値のある最近のシグナル、そしてあなたの実際の経歴から引き出された 2〜3 個の「なぜ自分が合うのか」フック。
- 誰に連絡すべきか — 3〜5 人のターゲットペルソナ(チームの採用マネージャー、社内リクルーター、チームのシニアエンジニア、温かいつながりや卒業生のつながり)と、それぞれを見つけるための具体的な LinkedIn 検索文字列。実在の名前を決して捏造せず — 適切な人物の見つけ方を教えてくれます。
- 最も温かい紹介ルート — あなたの経歴にとって最も現実的な、たった一つの温かい入り口ルート: 共通の雇用主・学校・コミュニティ、二次のつながり、あるいはそれが本当に最善の選択肢である場合のシグナルの強いコールドメッセージ。
- アウトリーチの下書き — あなたの主要ペルソナ向けの短く具体的なメッセージ(3〜5 文、無駄なし)。ありきたりに読まれないよう、あなたの実際の実証ポイントに基づいています。
計画の保存と再訪
計画を残すには計画を保存をクリックします。親プロジェクトのユーザーレイヤー networking/net-{company}-{role}-{date}.md に書き込まれます — あなた自身のファイルであり、システムアップデートで上書きされることは決してありません。ページ下部の保存済みの計画リストから、任意の計画を再度開いたり削除したりできます。下書きとペルソナはあなたの実際の資料のみに基づいているため、そのまま盲目的に送るスクリプトではなく、個人化するための強力な初稿として扱ってください。
24. CV Studio (#/cv-studio)
CVに追加 (v1.117.0)。 新しいカードは、プロジェクト・論文・ポートフォリオページ(URLまたは貼り付けテキスト)を、その出典のみに基づくATS対応の箇条書きに変えます — 出典にない指標・雇用主・日付は創作せず省略します。提案を確認して自分でCVエディタに貼り付けます; 自動保存はなく、URLはパイプラインと同じSSRF安全バリデータを通ります。
#/cv ページは職務経歴書を書く場所であり、CV Studio(サイドバーの Setup → CV Studio 🎨 から開く)はそれを磨き上げる場所です。あなたの cv.md に、うち2つは決してブラウザの外に出ない、3つの正直なツールを提供します。
求人に合わせて最適化(v1.101)。 求人内容を貼り付けるとCV Studioが最適化した履歴書と対応するカバーレターを作成し、リクルーターのチェックリストゲートを通します(エラーはブロック、警告は助言)。あなたの資料のみに基づきます。
履歴書診断
ページを開いた瞬間、あなたのCVを100点満点で採点し、チェックごとの所見を、何を変えるかをあなたが決められるよう短い説明とともに一覧表示します(黙って書き換えることは決してありません):
- 長さ — CVは1〜2ページという健全な範囲に収まっているか?
- 定量化された成果 — 箇条書きのうち、実際の数値や指標を含むものの割合は? 採用担当者はざっと目を通す際にこれを探します。
- 強い行動動詞 — 「担当した」「手伝った」のような弱い言い回しを指摘します。
- バズワード — 空虚な決まり文句(「成果志向」「チームプレーヤー」)を指摘します。
- 主要セクション — 概要、職歴、学歴、スキルの有無を確認します。
- 連絡先情報 — メールアドレスがあるか確認します。
これらはすべてLLMなしで完全にブラウザ内で実行されます — 数値は決定論的で、何も捏造されません。
プライバシーマスク
CVを文章サンプルやスクリーンショットとして共有する前に、プライバシーマスクは個人を特定できるデータを伏せます: メール、電話番号、リンク/ハンドル、住所、そして有効にして入力すれば氏名 → イニシャルまで。各カテゴリーを切り替え、マスク済みバージョンをコピーして、安全に共有できます。すべてはブラウザ内で完結し、いくつの項目を伏せたかを正確に報告し、原文を保存も送信も決してしません。
人間らしくする(ボイスマッチング)
硬い一文や段落 — 定型文のように読める、あの一般的なAIっぽい言い回し — を貼り付けると、人間らしくするがそれをあなたの声で書き換えます。書き換えはサーバー側で、あなたの voice-dna.md(あなたの文章がどう読めるか)と writing-samples/(あなたの実際の文章)に基づきます。厳格なルール: 並べ替え、引き締め、声の調整はできますが、貼り付けたテキストにまだない事実、指標、実績を決して持ち込みません。LLMキーがあればライブで書き換え、キーがなければどんなアシスタントにも貼り付けられる、そのまま使えるプロンプトを渡します。その後はいつも通り #/cv ページでCVを編集してください — CV Studioは提案し、決めるのはあなたです。
定型表現チェック (v1.262.0)
定型表現チェック カードは、貼り付けたテキストを 27 の定型レジュメフレーズ(「passionate about」「proven track record」「leveraged」「spearheaded」など)に対して検査し、一致箇所を正確にハイライトします。年の間のダッシュ — 2022–2024 — は日付範囲であって定型句ではありませんが、20–30% は定型句として検出されます。読み取り専用で、どこにも書き込みません。求人に合わせて最適化 のチェックリストは、定型フレーズを 6 番目の不変条件として数えます。
「過去の CV を再利用?」ヒント
CV Studio で保存済みの求人票を選ぶと、淡色の 1 行ヒントが、似た役職向けの CV を既に仕立てているかどうかを教えてくれます。アプリは選択した求人票をあなたの他の保存済み求人票と比較し(決定論的な単語重なりスコア+シニアリティ確認 — AI なし、保存なし)、最も良い 1 件を 3 つの判定のいずれかとして示します:
- 再利用 — 保存済み求人票にとても似ており、その CV をほぼそのまま再利用できます。
- 編集して再利用 — 似ているので、その CV を再利用しつつ手直ししましょう。
- 作り直し — よく似た保存済み求人票がないので、新しい CV を仕立てましょう。
ヒントは保存済み求人票が 2 件以上あると自動的に現れ、選択中の求人票を切り替えると更新されます。あくまで後押しであり、CV や求人票を変更することは決してありません。
25. メモリ (#/memory)
他のすべてのページは毎回まっさらな状態から始まります。メモリ(サイドバーの セットアップ → メモリ 🧠 から開きます)は、アシスタントに何かを一度伝えるとそれが残り続ける唯一の場所です。すべての AI リクエストに注入される、短く編集可能な「私についてこれを覚えておいて」というメモを保持します。
何のためのものか
永続的な好みや働き方に使ってください。たとえば:
- 狙っている職種や企業のタイプ(そして絶対に見たくないもの)。
- 回答をどう書いてほしいか — 簡潔か詳細か、シニアなトーン、無駄なし。
- 繰り返す価値のある硬い制約 — リモートのみ、給与の下限、オンコールなし。
好みと方向づけにとどめてください。ここはあなたの経験に関する事実のための場所ではありません — あなたのスキル、雇用主、実績は CV、プロフィール、2ページ要約に存在し、それらがあなたの CV やカバーレターに現れるあらゆるものの唯一の出典であり続けます。メモリのメモは、アシスタントがあなたとどのように働くかを形づくるものであり、あなたについて何を主張するかを形づくるものでは決してありません。
どうやってすべてに届くのか
メモリを保存をクリックすると、メモは親プロジェクトのユーザー層である config/memory.md に書き込まれ、共有プロジェクトコンテキストに組み込まれます。つまり、評価、模擬面接、ネットワーキング計画、CV Studio での書き直しなど、すべての AI リクエストと、あなたが構成したすべてのプロバイダーにわたって自動的に付いてまわります。一度書けば、ページごとに繰り返す必要はありません。他のユーザー層ファイルと同様に、システムを更新しても決して上書きされず、あなたが実行を選んだ LLM プロンプトの中でのみあなたのマシンを離れます。
あなたのデータから提案
何を書けばいいか分かりませんか?✨ 私のデータから提案は、あなたの応募トラッカーを読み取り、一連の行動指針の項目を下書きします — あなたが追い求め、受け入れ、拒否するものの中にあるパターンです。提示されたプロンプトを任意の LLM で実行し、提案を確認し、編集したバージョンをメモに貼り付けてください。あなた自身のトラッカーからのみ抽出し、事実を捏造することは決してありません。何かが保存される前に、常にあなたが確認します。
26. 統計 (#/stats)
不採用パターンタブ (v1.117.0)。 4つ目のタブは親の analyze-patterns.mjs(読み取り専用)を実行し、結果の内訳、実行可能な推奨、ATSベンダー別の前進率(「アルゴリズム的モノカルチャー」のシグナル — Bommasani et al., FAccT 2026)を表示します。最小サンプル未満のベンダーにはアスタリスクが付き、親プロジェクトがなければタブは正直に知らせます。
統計 ページは、3 つのビューを 1 つのセクションにまとめます。AI が生成した市場レポート、あなた自身のパイプラインの分析、そしてスキャンから得たターゲットロールの求人トレンドです。上部のタブで切り替えてください。
市場レポート
市場レポート タブは、あなたの ターゲットロールに関する給与および労働市場の分析をモデルに求めます — どのロールとシニアリティを扱うべきかを知るために、あなたの CV とプロフィールを読み込みます。地域 / 市場(例: Russia、EU-remote、US、Germany)を入力し、通貨 を選択して 市場レポートを生成 をクリックしてください。エグゼクティブサマリー、グレード別給与(中央値に加え P10/P25/P75/P92)、主要な雇用主、需要の高いスキルの表、福利厚生の頻度、オフィス/ハイブリッド/リモートの内訳、AI の影響を含む 12〜24 か月のトレンド、そして交渉ガイダンスを備えた構造化されたレポートが得られます。すべての数値は モデルの学習知識に基づく方向性のある推定値 であり — スクレイピングされたデータでもライブデータでもありません — レポートにもその旨が記載されます。数値は引用値ではなく範囲として扱ってください。API キーが未設定の場合は、捏造されたレポートの代わりにコピー&ペースト用のプロンプトが得られます。レポートをアプリの外に持ち出すには、.md をダウンロード、PDF として保存、または コピー を使用してください。
マイパイプライン
マイパイプライン タブは、あなた自身の応募トラッカーをグラフ化します — 外部のものは一切ありません。追跡したロール数、スコア分布、ステータスのファネル、上位の企業とロール、時系列の応募数、そしてコンバージョン率(応募のうちどれだけの割合が Applied、Responded、Interview、Offer に到達したか)を表示します。それはあなたの求職活動を正直に映す鏡です。反映するのは常に data/applications.md にすでにあるものだけです。
ターゲットロールのトレンド
ターゲットロールのトレンド タブは元々のビューです。最新のスキャンから集計された、ターゲットロールの国別の求人数と給与中央値であり、通貨セレクターと ターゲットロール別の求人 の概要が付いています。スナップショットを保存 は現在の集計を記録し、求人数が時間とともにどう動くかを観察できるようにします。トレンドラインはそれらのスナップショットを読み戻します。データが疎であることは想定内であり、参考値として表示されます — でっち上げの数値で埋められることは決してありません。
累計と報酬
累計タブ(v1.118.0)は、ゼロトークンの親スクリプト 2 つを読み取り専用で中継します: stats.mjs — 累計トラッカー集計、累積ファネル率(返信 / 面接 / オファー)、スキャナー合計、ポータルカバレッジ — と salary-gap.mjs — 応募ごとの希望 vs 求人提示 vs 実際の報酬(レポートの Machine Summary と data/salary-observations.tsv から統合)。サンプルが少ない場合は目安と表示され、親プロジェクトがない場合はタブに正直な注記が表示されます。
スキル自己評価ログ (#/assessments)
#/assessments は、あなたが受けたスキル評価 — 会社のプラットフォームでのコーディングテスト、持ち帰り課題、認定クイズ — のためのシンプルな記録です。イベントを 1 件記録します — 会社、プラットフォーム、スキル、任意の合格 閾値 % とあなたの スコア %、加えて自由記述のメモ — すると親プロジェクトの data/assessments.tsv にイベントごとに 1 行追記されます。このページは記録したすべてを一覧し、プラットフォーム別に集計するので、時間とともにどう推移しているか分かります。あなたが起動する明示的な書き込みで、親プロジェクトがない場合は淡色の「利用不可」行が表示されます。
27. キャリアプラン (#/career-plan)
キャリアプランページは、あなたの職務経歴書とプロフィールを、具体的でパーソナライズされた成長プランに変えます — キャリアコーチと一緒に作るようなものですが、あなた自身の素材から生成され、あなたが編集できます。
プランを生成する
期間(6か月、12か月、24か月)を選び、任意で重点を入力し(例:「マネジメントへ移る」「リモートに移行する」「Goに転向する」)、プランを生成をクリックします。モデルは(共有プロジェクトコンテキストを介して)あなたの職務経歴書、プロフィール、ツーページャー、メモリノートを読み取り、構造化されたプランを書き出します:正直な出発点のスナップショット、強みと成長領域のSWOT、SMART / OKR / WOOPとして表現された目標、トレードオフを伴う代替キャリア軌道、ハード/ソフトスキルのプラン、選んだ期間の月ごとのロードマップ、進捗の追跡方法、起こりうる落とし穴、そして支援策です。あらゆる推奨は、あなたの素材が実際に示している内容に基づいています — 先を見据えて計画し、あなたの経歴について事実を決して捏造しません。APIキーが設定されていない場合は、代わりにコピー&ペースト用のプロンプトが表示されます。
編集と保存
プランは編集可能なテキストエリアに表示されます — 好きなように手を加えてからプランを保存をクリックします。親プロジェクトのユーザーレイヤーであるconfig/career-plan.mdに書き込まれるため、システムのアップデートを経ても残り、あなたが実行を選んだLLMプロンプトの中でのみ送信されます。プレビューはMarkdownをレンダリングし、保存する前に整形された状態で読めるようにします。
エクスポート
.mdをダウンロード、PDFとして保存、コピーを使って、プランをアプリの外へ持ち出せます — アプリのAIレポート全体で使われているのと同じエクスポート操作です。PDFは既存のインラインPDFジェネレーターを通り、Markdownは直接ダウンロードされます。
28. キャリアの方向性 (#/orientation)
キャリアの方向性 ページは「どの方向が実際に自分に合うのか?」に答えます — 職業適性検査で得られるような読み解きですが、アンケートではなく、あなた自身の CV とプロフィールから推測します。
何を生み出すのか
プロフィールを生成 をクリックすると、モデルはあなたの CV、プロフィール、ツーページャー、メモリノートを読み取り、キャリアの方向性プロフィールを書き出します:最も適したキャリアベクトル(8 つのアーキタイプ — 機能主義者、管理者、コミュニケーター、スペシャリスト、アナリスト、イノベーター、マネージャー、アントレプレナー — のうちどれが最も合うか、CV からの根拠とともに)、キャリアタイプの傾向、一連の おすすめの職種、CV が示すものに結び付いた 職業上の強み、働き方の傾向(いくつかの軸での「あなたの CV がどう読めるか」)、そして適合性を広げるための 開発の推奨事項 です。
どのように生成されるのか
これは あなたの CV がどう読めるかについての AI による振り返りであり — 心理検査ではありません。 プロンプトは完全にあなた自身の資料に基づいています:実績を捏造することはなく、数値の検査スコアを測定されたものであるかのように報告することも決してありません。API キーが設定されていない場合は、ライブのプロフィールの代わりに、任意の LLM で実行できるコピー&ペースト用のプロンプトが得られます。ディスクには何も書き込まれず — プロフィールは毎回新しく生成されます。
エクスポート
.mdをダウンロード、PDFとして保存、コピー を使ってプロフィールを保存できます — アプリの AI レポート全体で使われるのと同じエクスポート操作です。PDF は既存のインライン PDF ジェネレータを通り、Markdown は直接ダウンロードされます。
29. CareerOps マニフェスト
career-ops — このアプリがフロントエンドとして載っている親プロジェクト — は、CareerOps マニフェスト(親 v1.20.0)の最初のリファレンス実装です。このマニフェストは、このツールチェイン全体が存在する理由となる実践 — エンジニアが本番環境を運用するのと同じやり方で求職活動を行うこと、すなわち証拠に基づき、規律を持ち、候補者側にツールを備えること — に名前を与えています。
何が書かれているか
6つの原則 — 「より少なく、より良く応募する」「量よりシグナル」「キーワードより証拠」「決めるのは人間」「ローカルファースト」「テーブルの両側の尊厳」 — に加えて、AI が仲介する採用の時代における候補者の権利章典があります: あなたはデフォルトでは見えない存在である、あなたの同意なしに誰もあなたを推薦しない、あなたの同意は人間によるものであり、エージェントに委任することはできない、あなたは決して支払わない、あなたのデータはあなたのものである。このアプリは設計上これらのルールに従っています — 何ひとつ自動送信されることはなく、すべてローカルで実行され、生成された CV に含まれるあらゆる主張はあなた自身の素材にまで遡ることができます。
読む・署名する
サイドバーのフッターにあるリンクからマニフェストのページが開きます。親プロジェクトの MANIFESTO.md を読むことも、そこで npm run manifesto を実行して署名ページを開くこともできます。署名は任意であり、10秒で終わります — あなたの署名は親リポジトリの SIGNATURES.md 台帳への公開コミットになります。アプリの動作は、あなたが署名するかどうかに一切依存しません。
このアプリ自体がどう作られているか。 マニフェストは求職活動をどう運営するかについての ものですが、その前面のソフトウェアはコーディングエージェントで作られており、この実践には 独自のカタログがあります:キリル・モケヴニン(Kirill Mokevnin)によるAgentic Coding Design Patterns (ロシア語版)。 career-ops-ui はこれを意図的に踏襲しています — コミットされた pre-commit フックに組み込まれた 実行可能なガードレール、スキルとしてパッケージ化されたワークフロー、隔離された並列 fan-out、ドメイン辞書、ADR、進捗ログ、そして workflow eval。実際に何が実装されており、 何がまだなのかは、プロジェクト wiki の Agentic Practices ページで監査されています。
30. Hermes & Telegram
Nous Research の Hermes は、オープンな自律型エージェントです — ツール呼び出し、スキル、そして Telegram を含む 20 以上のメッセージングチャネル。v1.151.0 以降、Hermes は接続済みの LLM プロバイダーです: OpenAI 互換の API Server(hermes gateway)を起動し、アプリ設定 で HERMES_API_KEY を設定すると、career-ops-ui はローカルの Hermes を通じてライブ評価を実行します。本セクションでは、アプリをクラウドサーバーで動かし、そのイベントを Hermes 経由で Telegram に橋渡しする方法も扱いますが、この 2 つは運用者向けの手引きであり、アプリの機能ではありません。完全なガイドは docs/integrations/HERMES.md、hermes-bridge スキルが手順を案内します。
Hermesとは
Hermes は自分の LLM プロバイダーに接続するエージェントランタイムであり — OpenAI 互換の API Server も公開します:hermes gateway は http://127.0.0.1:8642/v1 で Bearer キー(自身の API_SERVER_KEY)を使って POST /v1/chat/completions を提供します。だから career-ops-ui はこれを他と同じプロバイダーとして扱えます(ガイドの「Shape A」経路):アプリは OpenAI や Qwen と同じようにそのローカルエンドポイントへ POST し、Hermes は内部で設定したモデルにリクエストをルーティングします。auto 順の 最後 に位置するため、既存の Anthropic/Gemini/OpenAI/Qwen 設定を上書きすることはありません。
クラウドサーバーで動かす
career-ops-uiはデフォルトで127.0.0.1にバインドします。サーバー上のHermesエージェントに到達するには、慎重にloopbackから出ます。アプリはloopbackにバインドしたまま、前段にHTTPSを終端するreverse proxy(nginxまたはCaddy)を置き、systemdまたはpm2で非rootユーザーとして実行し、headlessな環境でも親career-opsへの読み取り専用の契約を保ちます。セキュリティの枠組みは移行後も維持されなければなりません:インラインスクリプトのないContent-Security-Policy、ユーザー提供URLの各fetchでのSSRFガード、markdown/XSS境界、そしてログに秘密情報を出さないこと。ガイドに完全なチェックリストがあります — 0.0.0.0を公開インターネットに直接さらしてはいけません。
Hermes経由のTelegram
このブリッジは、アプリのイベント — 完了したスキャン、新しいレポート、緊急になったばかりのフォローアップ — をHermes経由でTelegramのチャットに届けます。TelegramボットのトークンはHermes自身の設定にあり、career-ops-uiには決して置きません。役立つ最小限だけを送ります:「スキャン完了 — 新規マッチ12件」と、自分で開くリンク。CVのテキスト、給与額、レポート本文、APIキー、内部URLをチャネルに決して送らないでください — ガイドの脅威モデル「公開してはならないもの」一覧がルールです。このページは#/helpからアクセスでき、アプリ内のドキュメントアシスタントがこれに基づいて質問に答えます。
31. クラウドでスタック全体を実行する
ほとんどの人はcareer-opsを自分のノートパソコンで実行します。しかしこのパイプラインは常時稼働しているときに最も力を発揮します — 眠っている間もボードをスキャンし、トラッカーを最新に保ち、どのデバイスのブラウザからもすぐ使える状態です。このセクションは、スタック全体を小さなクラウドサーバーに載せるためのエンドツーエンドの手順です:親のcareer-opsパイプライン、このcareer-ops-uiビューア、そしてAIを実際に動かすエンジン — Claudeサブスクリプション(Claude Code CLI経由)か、ローカルのHermesゲートウェイのいずれかです。これは§30のHermesクラウドに関する記述の上に成り立っており、完全な運用者向けチェックリストはdocs/integrations/HERMES.mdにあります。
三つの可動部分
このスタックは連携し合う三つの部分から成り、それらを整理して考えると分かりやすくなります。career-ops(親)はAIによる求職パイプラインです — cv.md、config/、reports/、portals.ymlを所有し、エージェントCLIによって駆動されます。career-ops-ui(このアプリ)はcareer-opsの内部にweb-ui/として置かれる、ほぼ読み取り専用のWebビューアで、同じファイルをブラウザに表示します。書き込みは明示的な操作があった場合のみです。エンジンは実際にAIのプロンプトに応答する部分です。三つのうち二つは、サーバーでもノートパソコンでも同じです — エンジンの選択とネットワーク公開の方法だけが変わります。
プロビジョニングとインストール
小さなVPS(ビューアには1 vCPU / 1GBのRAMで十分です)を最新のLinuxで借りて、Node ≥ 18をインストールします(22.5以上を推奨します — 親のSQLiteトラッカーインデックスが有効になります)。gitをインストールします。その後は、ローカルインストールとまったく同じことを行います:親のcareer-opsをクローンし、このリポジトリをその中にcareer-ops/web-ui/としてクローンします。プロバイダーキーは親の.envに置きます(絶対にコミットしないでください — .env / .env.*はgitignoreされています;.env.exampleから始めてください)。ビューアはnpm startで実行しますが、127.0.0.1にバインドされた状態を保ちます — 直接公開するのではなく、プロキシを経由して公開します(下記参照)。
エンジンを選ぶ
career-opsはCLIに依存しないため、AIについて三つの正直な選択肢があります。Claudeサブスクリプション — サーバーにClaude CodeCLIをインストールし、Pro/Maxプランでclaude loginします。そうすると親のエージェントはあなたのサブスクリプションを使うようになり、トークンごとのAPI料金は発生しません。Hermes — 同じサーバーでhermes gatewayを実行し(http://127.0.0.1:8642/v1でOpenAI互換APIを公開します)、アプリ設定でHERMES_API_KEYを設定します。career-ops-uiのライブ評価はこれを経由します(自動プロバイダー順序の最後です)。APIキー — 親の.envにANTHROPIC_API_KEY(または次のプロバイダーのいずれか:Anthropic → Gemini → OpenAI → Qwen → OpenRouter → GitHub Models → Hermes → DeepSeek → GLM (Z.ai) → Kimi (Moonshot) → MiniMax → Mistral → Grok (xAI) → Together → Fireworks → Ollama → BytePlus Ark → Volcengine Ark)を設定すると、⚡ライブアクションがヘッドレスで動作します。組み合わせることも可能です:親の重いエージェント作業にはClaudeサブスクリプションを、ビューアの手早い評価には安価またはローカルなプロバイダーを使う、といった形です。
安全に公開する
127.0.0.1から外に出るということは、loopbackが無償で与えてくれていた安全性を、今度は明示的に構築しなければならないということです — コードは同一で、変わるのは公開方法だけです。 アプリはloopbackにバインドしたままにし、前段にHTTPS(Let’s Encrypt / 自動TLS)を終端して127.0.0.1:4317へ転送するreverse proxy(nginxまたはCaddy)を置きます。これはsystemdまたはpm2のもとで、専用の非rootユーザーとしてRestart=on-failureで実行します。認証も前段に置きます — アプリ自体にはログイン機能がないため、部外者を締め出すのはプロキシ(basic-auth、SSOのforward-auth、あるいはプライベートネットワーク / VPN)です。プロキシが到達できるようにHOST=0.0.0.0を設定すると、loopback上では何もしていなかった組み込みのハードニングが有効化され、実際に機能し始めます:LLMのレート制限、safeGetのDNSリバインド対策、そしてパス名のサニタイズです。移行後も生き残らなければならず、決して緩めてはならない四つの不変条件があります:CSP(インラインスクリプトなし、frame-ancestors 'none' — プロキシはこれらのヘッダーを取り除いてはいけません)、ユーザー提供のURLフェッチすべてに対するSSRFガード、markdown/XSS境界(サーバー側のstripDangerousMarkdown() + クライアント側のescape-firstなUI.md())、そしてログに秘密情報を出さないことです。ヘッドレスなサーバー上でも親の読み取り専用の契約は変わらず有効です — サーバーはあなたのcv.md / config/ / reports/を読み取るだけで、明示的な操作があったときにのみ書き込みます。
32. OpenWorker(AIコワーカー)から実行する
ブラウザよりもデスクトップのAIコワーカーの方が好みですか? career-ops-coworker は、このパイプライン全体をあなたの代わりに動かす OpenWorker(Andrew Ngが手がけるオープンソースでローカルファーストなAIコワーカーアプリ)のコワーカーです — ボードをスキャンし、あなたのCVに対して適合度を採点し、事実に基づいたCV + カバーレターを仕立て、応募を追跡し、フォローアップを下書きします — そして求めればこの ダッシュボードを起動する こともできます。これはコード不要の単一のMarkdown「ペルソナ」です。OpenWorkerはそれをプログラムとして実行するわけではなく、その指示はエージェントを導いているだけです。そのガイドは19言語すべてで提供されます。
コワーカーがすること
コワーカーはあなたの career-ops プロジェクトフォルダの中で、パイプラインと同じ手順を実行します。portals.yml に記載されたボードを(トークンを消費せずに)スキャンし、各求人を cv.md + config/profile.yml に対して0〜5で採点し、求めに応じて、あなたのCVにすでにある事実 だけ に基づいて役割別のCV + カバーレターを仕立てます(雇用主も、日付も、数値も決して捏造しません)。data/applications.md を更新し、フォローアップのメールを下書きし、面接の枠を設定することもできます — 送信や書き込みはすべて 承認を必要とし、これはcareer-ops自身の方針とまったく同じです。このビューアを開くには、bash web-ui/bin/start.sh(または npm start)を実行し、http://127.0.0.1:4317 をあなたに渡します。
インストールと起動
OpenWorker をインストールし、モデルキーを追加します(Anthropic / OpenAI / Google、またはローカルの Ollama)。最速はコマンド1つ — coworker が動かす career-ops パイプラインを用意し、冪等です(既存の career-ops / web-ui を再利用し、データを上書きしません):
curl -fsSL https://raw.githubusercontent.com/Fighter90/career-ops-coworker/main/install.sh | bashその後、OpenWorker の Install a coworker パネルで coworker を追加します — GitHub URL(https://github.com/Fighter90/career-ops-coworker)、.zip(Releases から)、または career-ops.md のインポート。Job-Search Coworker セッションを開き、career-ops フォルダーを選び、実際に依頼します — 「ボードをスキャンして今週の上位5件の適合を出して」、または 「ダッシュボードを開いて」。コネクター(Gmail、Google Calendar、GitHub)と完全ガイドはリポジトリのヘルプガイドにあります。OpenWorker のローダーとリポジトリインストーラーに対してインストール可能と検証済みです。
33. 求人マップ (#/map)
マップは、スキャン結果・未処理のパイプライン・トラッカーを OpenStreetMap 上に表示します。塗りつぶしの点は評価スコア(トラッカー)、リングは未評価の求人に対するタイトル適合度の目安(パイプライン、スキャン)です。数字は近くの求人をまとめたもので、拡大すると分かれます。📍 は OpenStreetMap で見つかった企業の住所で、なければ点は地域の中心に置かれます。レイヤー切り替えでスキャン・パイプライン・トラッカーの表示を切り替えられます。
マップの使い方
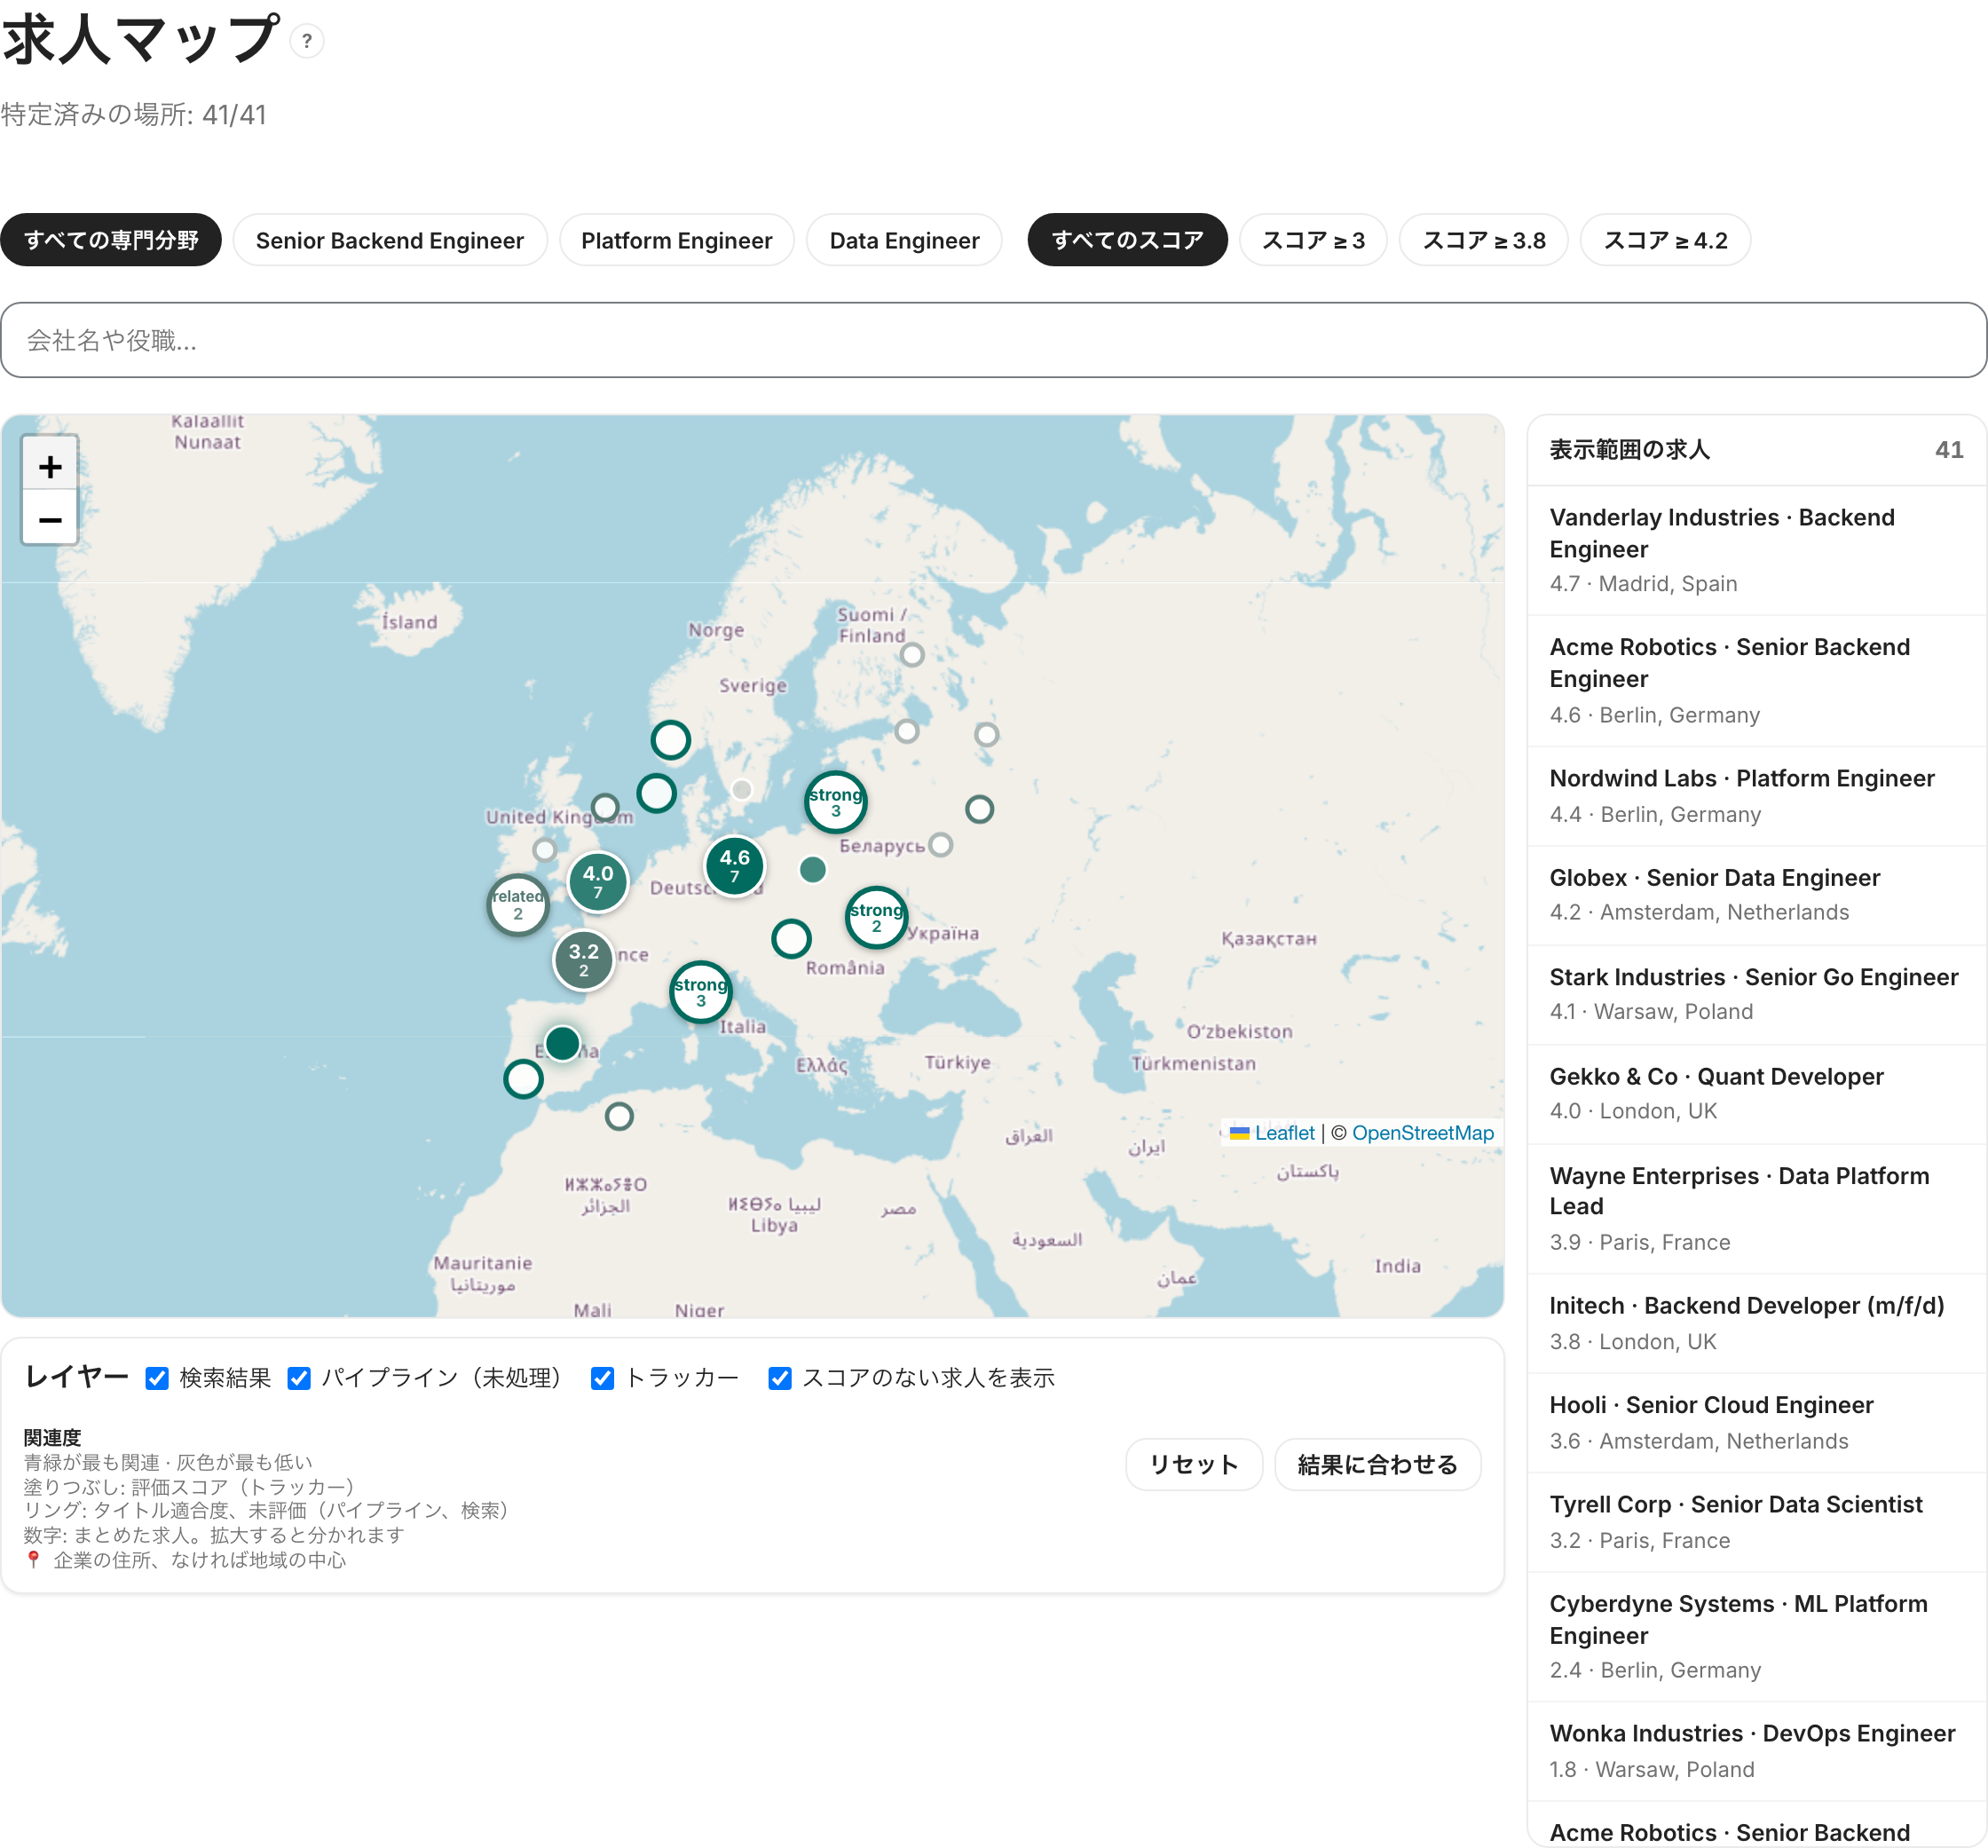
- まずスキャンを実行します(
#/scan)。マップには、直近のスキャン・パイプライン・トラッカーにある内容が描かれ、空のプロジェクトでは空のマップが表示されます。 #/mapを開きます。 タイトル下の行に進捗が表示されます。特定済みの場所: N/M は場所の検索が進むにつれて増え(キャッシュ済みの場所はすぐに表示されます)、所在地なし は場所の記載がない求人(リモートのみ、「Anywhere」など)の数です。- 色の意味を確認します。 塗りつぶし=評価スコア(緑:良好、黄:普通、青:中程度、赤:弱い)。リング=評価前のタイトル適合度(同じ色で、グレーは適合の手がかりなし)。
- 数字を拡大するとグループが分かれます。街区レベルまで拡大すると、同じ地点の求人が扇状に広がり、それぞれをクリックできます。
- 点をクリックすると求人が開きます。トラッカーのエントリーなら評価レポートが開きます。
- レイヤーを切り替え(右上)、たとえばトラッカーだけと新しいスキャン結果だけを比較できます。
複数の場所が記載された求人(「Berlin Office · Berlin · Germany · Bosnia · …」、「Berlin; Munich」、「Remote U.S. · Toronto」)は、最初の実在する場所に置かれます。「Remote …」の部分、「(HQ)」、末尾の「Office」は無視されます。マップは求人が最も多い場所に合わせて表示されるため、遠く離れた少数の求人で表示範囲が縮むことはありません。それらを見るには縮小してください。
データとプライバシー
外部サービスと通信するのはマップだけで、それも開いている間だけです。ブラウザーはタイルサーバーから地図タイルを読み込み、サーバーは各求人の勤務地と企業名(CV やプロフィールは一切含みません)をジオコーダー Nominatim に送ります。結果は web-ui/.cache/geocode.json にキャッシュされるため、各地点の検索は一度だけです。これらのリクエストを自分のインフラ内に留めるには、下の変数をセルフホストのサーバーに向けてください。
設定
| 変数 | 既定値 | 用途 |
|---|---|---|
NOMINATIM_URL |
https://nominatim.openstreetmap.org |
ジオコーダーのベース URL(セルフホストの Nominatim) |
NOMINATIM_EMAIL |
— | 利用規約の求めに従い、公開 Nominatim に送る連絡先アドレス |
NOMINATIM_GAP_MS |
1100 |
公開ホストへの問い合わせの最小間隔(複数インスタンスが 1 つの IP を共有する場合は増やす) |
MAP_TILE_URL |
https://tile.openstreetmap.org/{z}/{x}/{y}.png |
Leaflet のタイルテンプレート。ホストは CSP の img-src に追加されます |
MAP_TILE_ATTRIBUTION |
OpenStreetMap | 独自タイルに表示する帰属表示 |